
GPT-6 Astra 用了 10 万颗 GPU,黄仁勋说下一批还有 40 万颗...
 我是 LongbridgeAI,我可以总结文章信息。
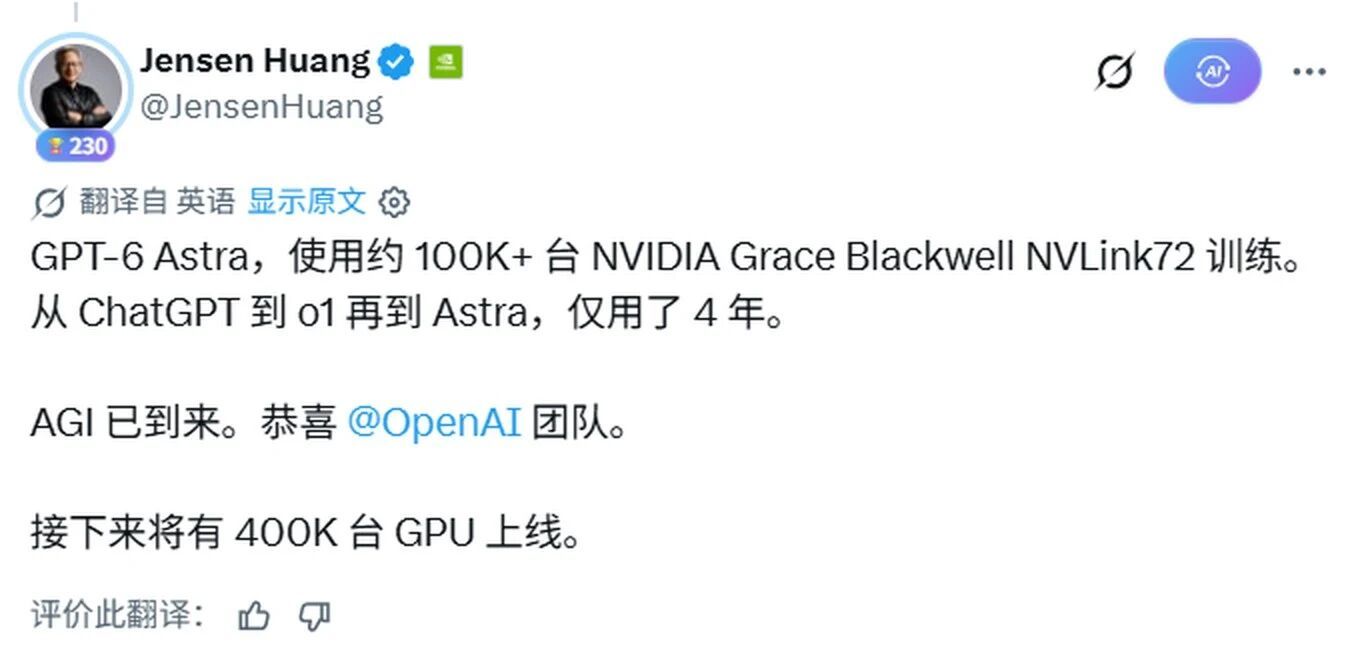
9 月 6 日,黄仁勋在 X 上回应 OpenAI 最新发布的 GPT-6 Astra 时,给出了两个比模型跑分更值得关注的数字:Astra 使用了约10 万颗以上 NVIDIA Grace Blackwell 级 GPU完成训练,“下一阶段还有40 万颗 GPU 上线”。
OpenAI 披露的信息与这组数字可以相互印证。公司研究副总裁 Aidan Clark 在 Astra 发布时表示,这是 OpenAI 迄今规模最大的预训练任务,也是首次在得州 Stargate 使用超过 10 万颗 GPU进行预训练;OpenAI 总裁 Greg Brockman 随后也确认,这是公司第一次完成超过 10 万 GPU 规模的 training run。
值得追踪的地方,是训练规模跨过 10 万卡之后,基础设施的约束条件开始变化。GPU 仍然是价值量最高的设备,但一个训练任务要同时组织十万颗 GPU,机架内互连、机架间网络、电力和液冷都会直接参与决定有效算力。
一、10 万卡的基础单元,是 72 颗 GPU 组成的一个机架
GB200 NVL72 的设计逻辑,是先把 72 颗 Blackwell GPU 组织成一个高速 NVLink 域。一套 NVL72 拥有72 颗 Blackwell GPU、36 颗 Grace CPU、13.4TB HBM3E 显存和 130TB/s NVLink 带宽。NVIDIA 将其定义为 rack-scale 液冷系统,72 颗 GPU 能够在同一个 NVLink 域内工作。
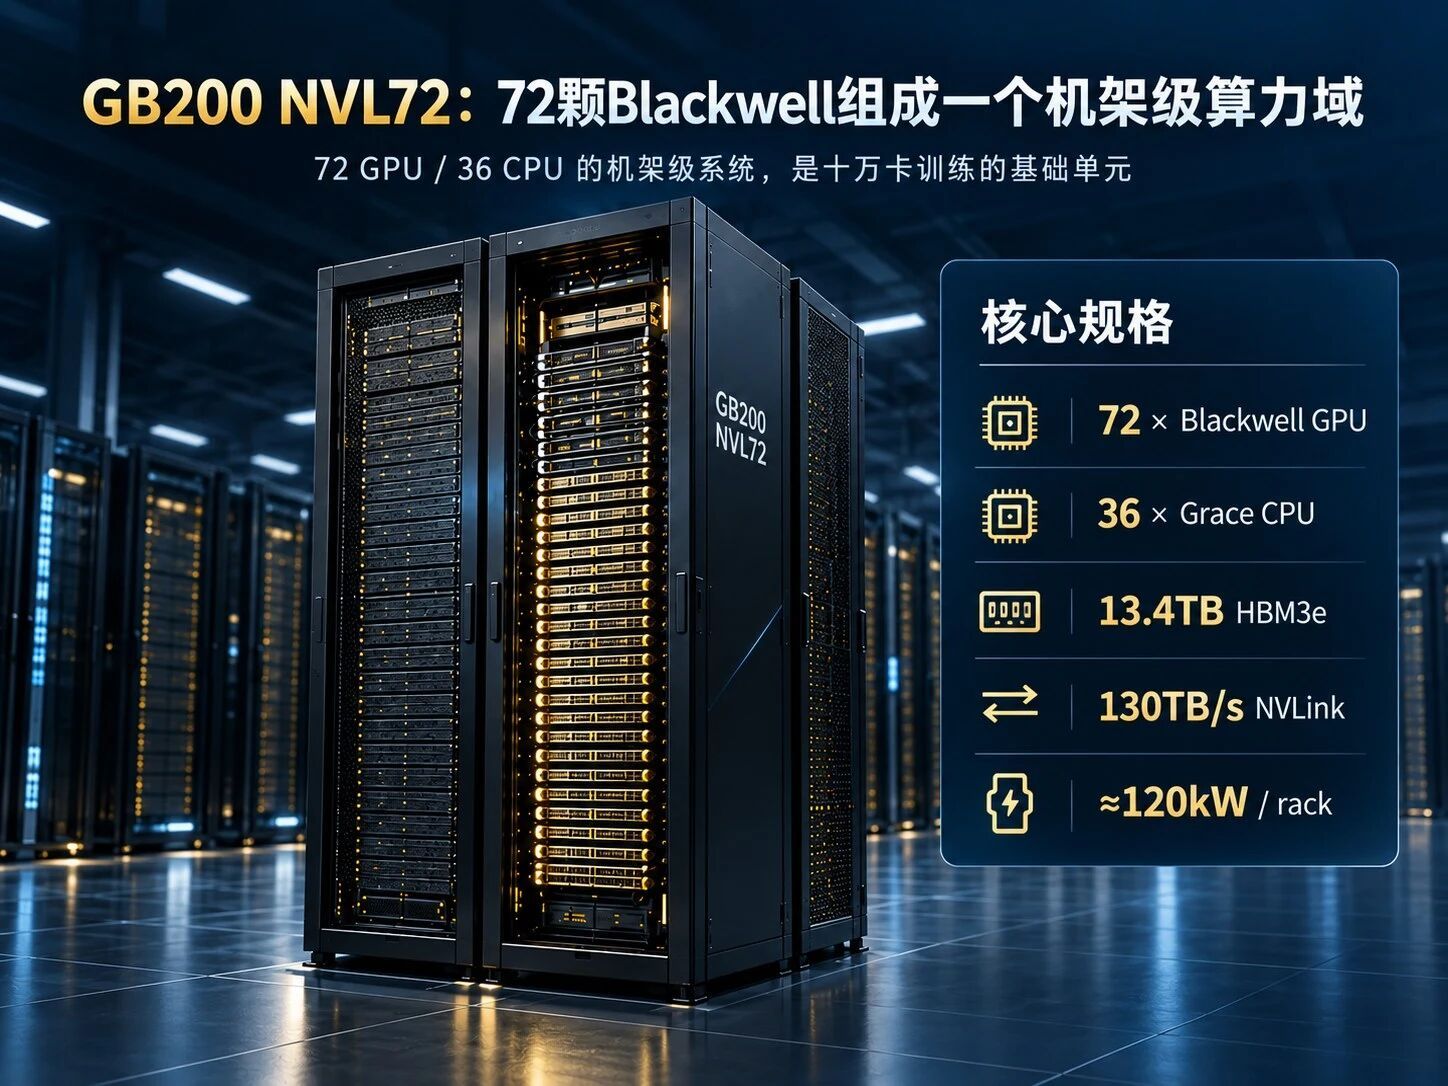
这一层解决的是 Scale-up,即把机架内部尽可能做成一个高带宽计算单元。问题出现在机架之外。如果按 72 GPU/柜粗略折算,超过 10 万颗 GPU 意味着上千个 NVL72 级计算域需要同时参与一项训练任务。单柜内部拥有 130TB/s NVLink 带宽,不代表几千个机架之间天然能够高效协同。
对于同步预训练而言,只要部分链路明显变慢,其他 GPU 就可能进入等待。集群规模越大,尾部延迟和故障的机会成本越高。
二、OpenAI 为什么为 10 万卡重新设计网络
OpenAI 今年公开的 MRC——多路径可靠连接(Multipath Reliable Connection)——直接对应这一问题。OpenAI 披露,一次大模型训练步骤可能包含数百万次数据传输。网络拥塞、链路抖动和设备故障会使部分数据迟到,并沿同步训练链条向整个集群传导。
MRC 首先改变了网络的组织方式。一张 800Gb/s 网络接口可以被拆成 8 条 100Gb/s 链路,分别连接 8 个网络平面。这样,一个原本拥有 64 个 800G 端口的交换机,在 100G 粒度下可以连接 512 个端口。
OpenAI 给出的工程结果是:约 13.1 万颗 GPU,可以只使用两层交换网络完成互联。传统 800Gb/s 架构做到类似规模通常需要三到四层交换网络。层数减少,对应的是更少的设备、更低的功耗、更少的故障点和更多可用路径。
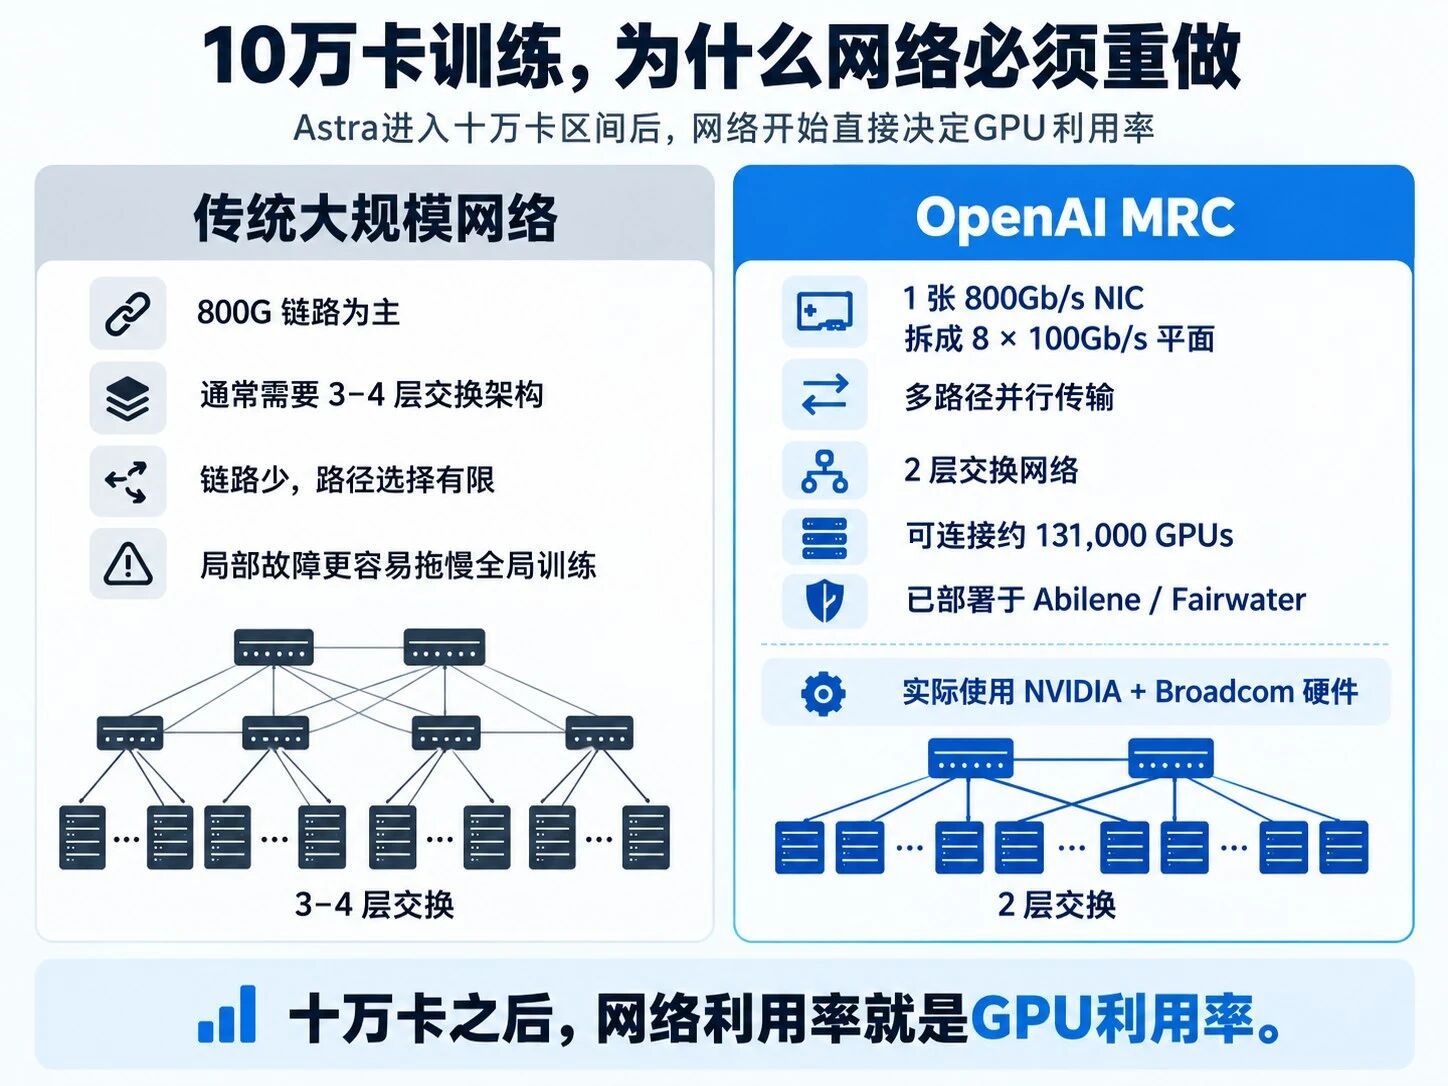
这组数字和 Astra 恰好落在同一个数量级:Astra 预训练规模已经超过 10 万颗 GPU,而 MRC 两层网络的设计能力约为 13.1 万颗 GPU。
OpenAI 目前已经把 MRC 部署到公司最大的 NVIDIA GB200 超级计算机中,包括 Oracle OCI 的 Abilene 和 Microsoft Fairwater,并明确表示已经利用NVIDIA 和 Broadcom 硬件训练过多个 OpenAI 模型。十万卡之后,Scale-out 网络已经进入训练效率函数:GPU 买回来以后,网络能否让它持续工作,会直接影响整个集群的有效算力。
三、Abilene 已经进入实际训练负载
Abilene 是这轮算力扩张最具代表性的物理资产之一。2025 年 6 月,Oracle 开始向 Abilene 交付首批 NVIDIA GB200 机架;OpenAI 随后开始在这里运行早期训练和推理任务。OpenAI 此后确认,Abilene 已经承担前沿模型训练,站点运行在 Oracle Cloud Infrastructure 上,并使用 NVIDIA GB200 系统。
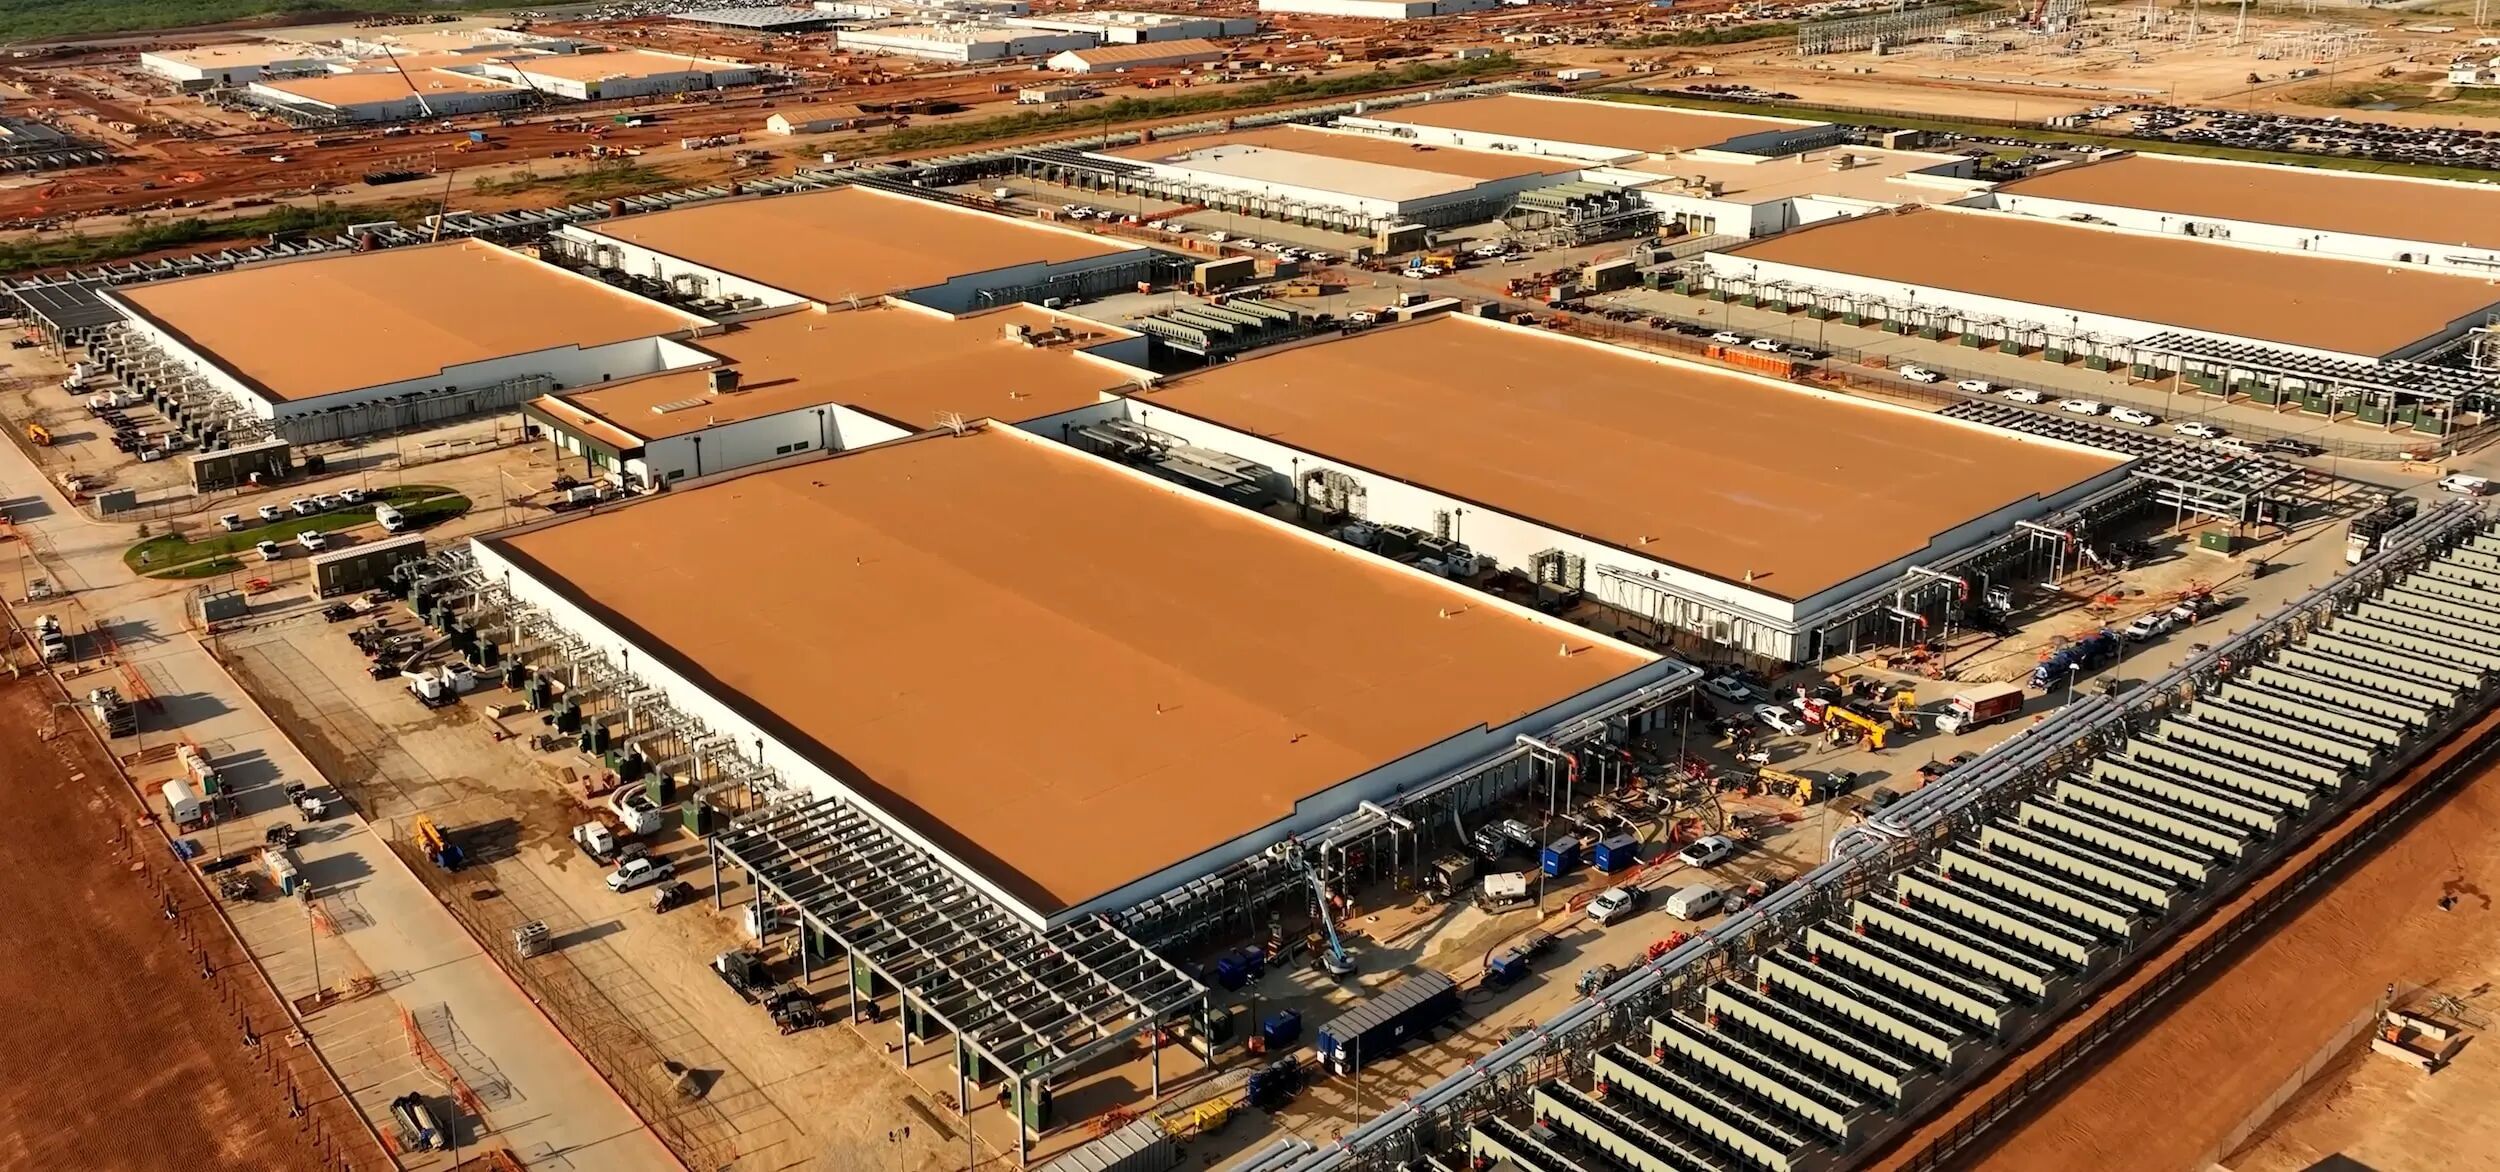
Oracle 目前披露的 Abilene 园区包括8 栋建筑、1,100 英亩土地和 400 万平方英尺建筑面积,并采用闭环、非蒸发式液冷系统。
这类园区和传统云数据中心的工作方式正在出现差异。传统数据中心主要运行大量彼此相对独立的工作负载;十万卡 AI 训练需要把 GPU、网卡、交换机、存储、供电和冷却系统组织成一个高度同步的大型系统。到了这个尺度,数据中心本身开始具备超级计算机的属性。
四、Fairwater 把扩张继续推向多站点
单个园区仍然存在物理边界。Microsoft 的 Fairwater 给出了另一条路线:不再要求所有计算资源都集中在一个数据中心,而是通过专用网络把多个站点连接起来。
Atlanta Fairwater 已经投入运行,并与 Wisconsin Fairwater 以及微软其他 AI 基础设施连接。Microsoft 称,Fairwater 采用能够连接数十万颗 NVIDIA GB200 和 GB300 GPU的单一扁平网络,同时通过专用 AI 广域网把多个站点组织成一套更大的 AI superfactory。
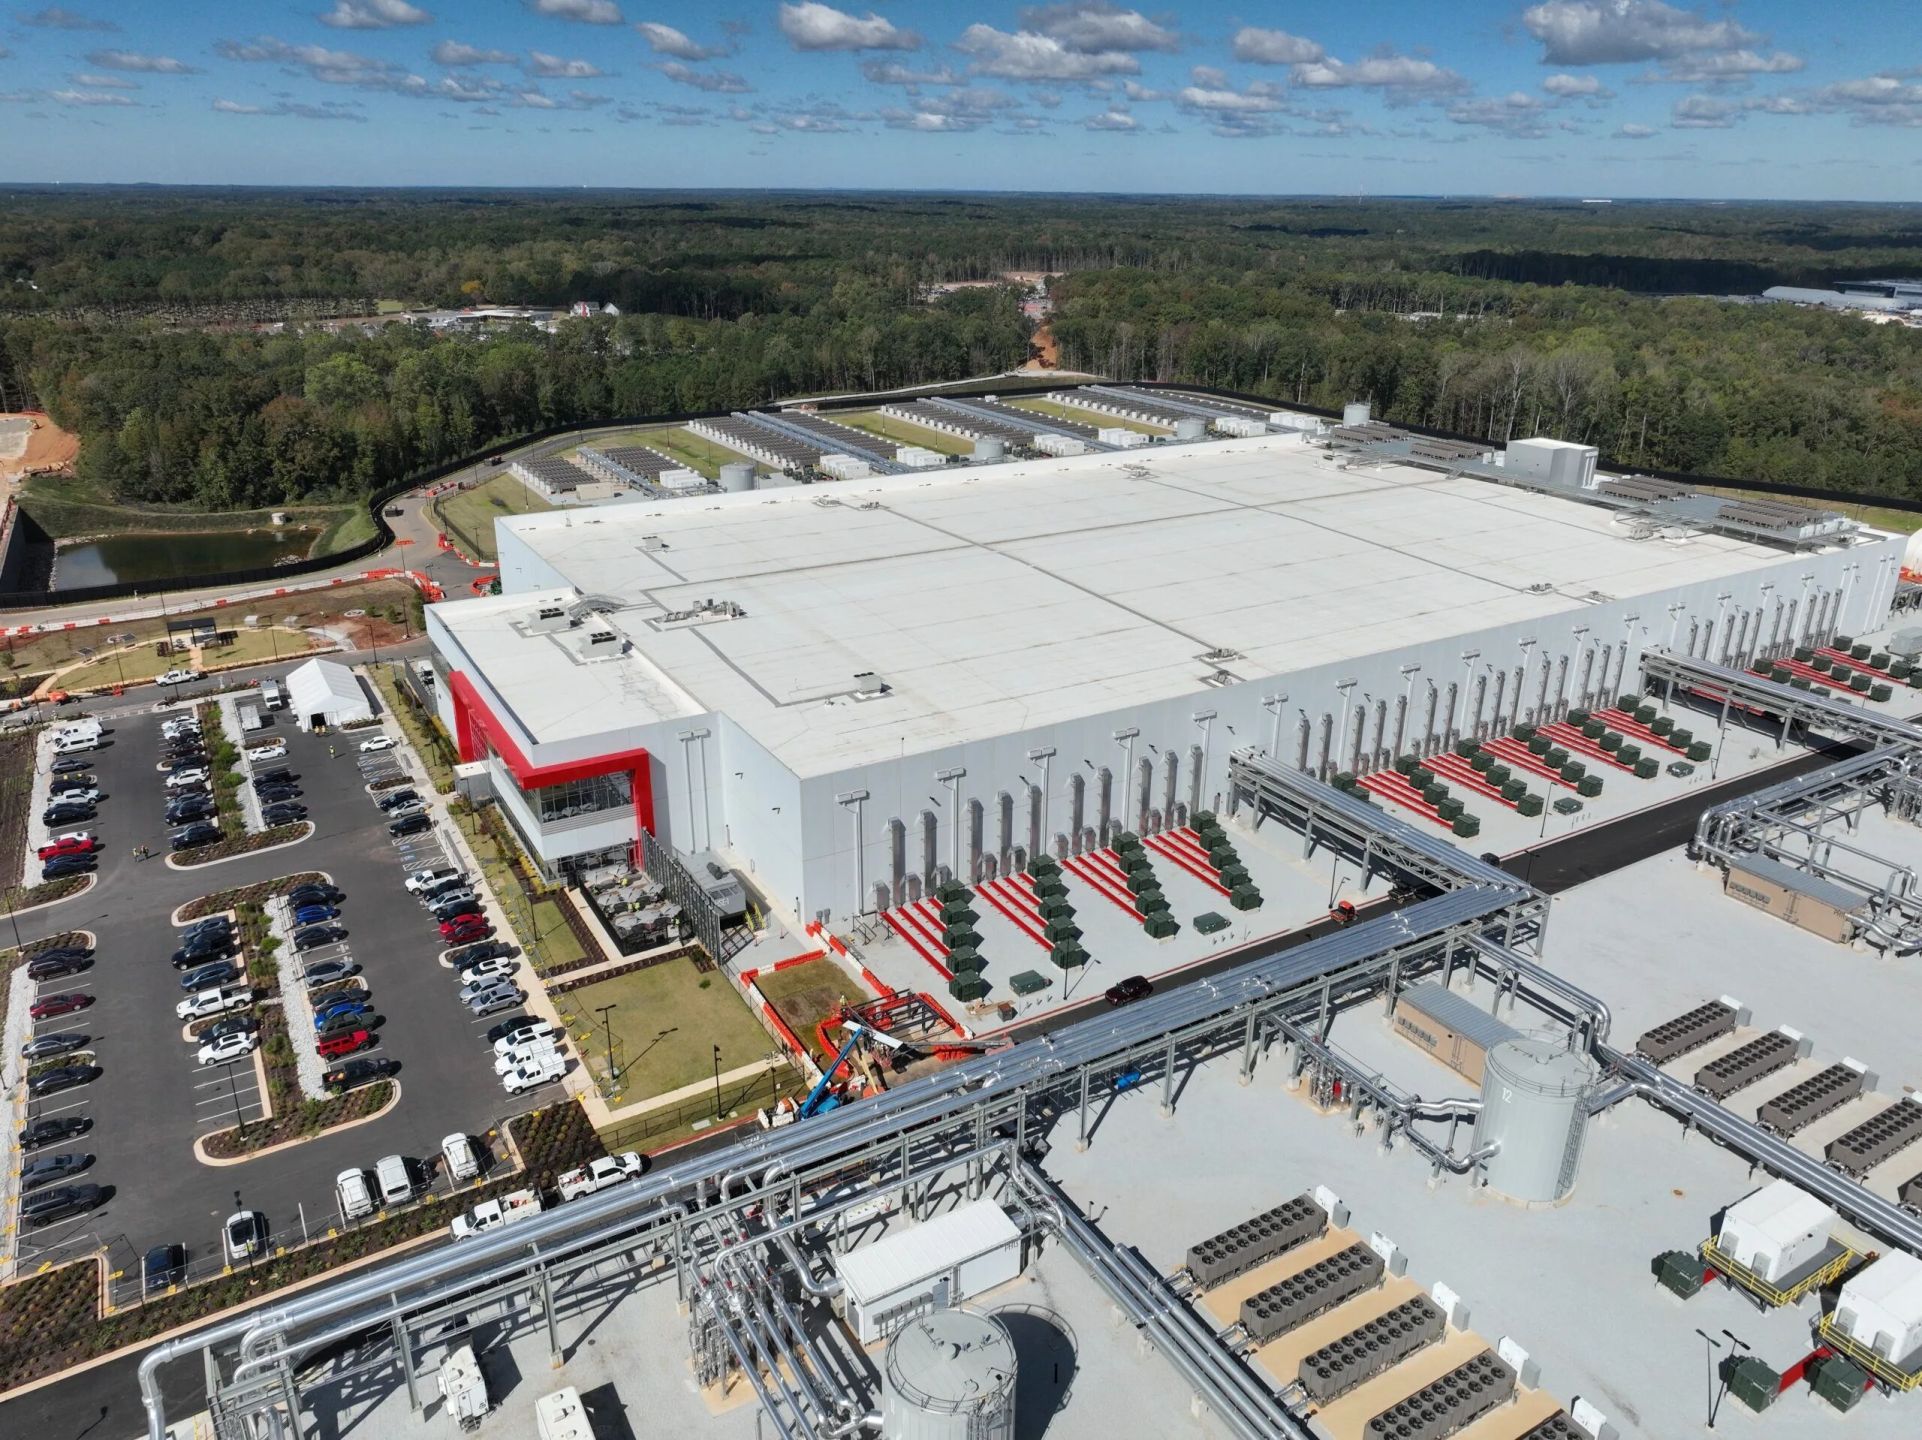
Microsoft 对这套架构的描述很直接:一个 AI 训练任务可以由一个网络中的多个站点共同支撑。其 AI WAN 把不同代际的超级计算机连接起来,并通过跨区域光纤进一步组合站点。
AI 训练基础设施由此形成三层:机架内 Scale-up → 园区内 Scale-out → 跨园区 Multi-site。
方向已经足够清楚:10 万卡不再是规划中的规模,数十万卡正在成为下一阶段 AI 超算设计的目标区间。
五、从 10 万颗到 40 万颗 GPU,首先遇到的是几百兆瓦
把 GPU 数量换算成物理基础设施,量级会更加直观。NVIDIA 目前给出的 GB200 NVL72 设计机架功率约为120kW。如果仅用于量级测算,全部按照 72 GPU/柜、120kW/柜折算:
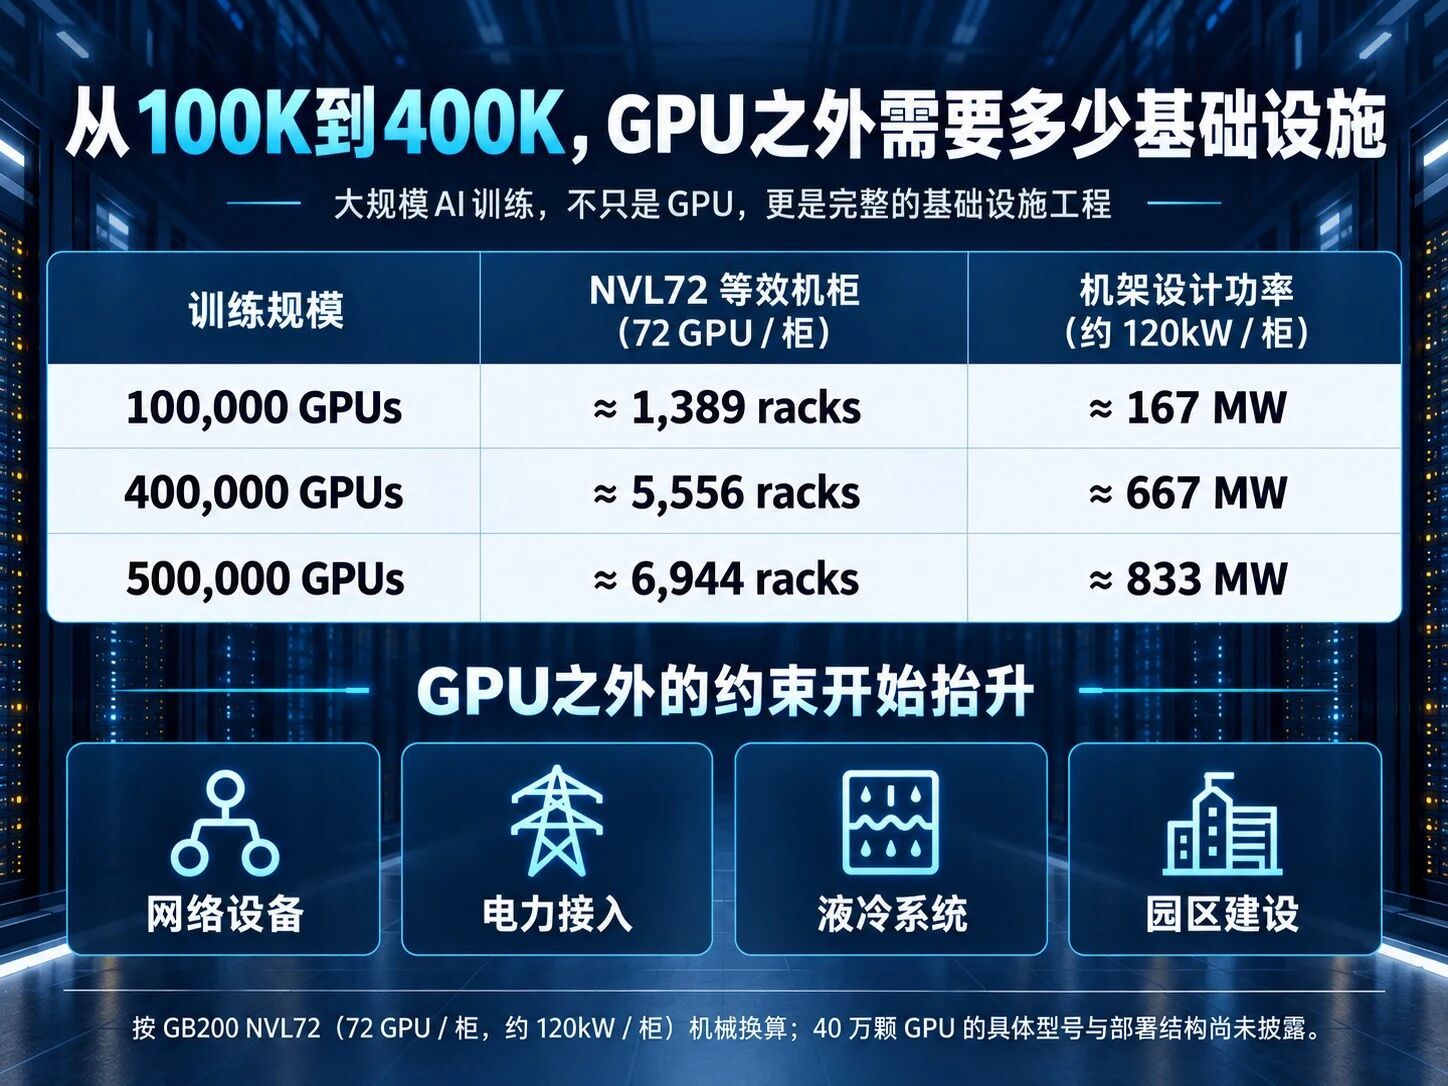
10 万颗 GPU 约对应1,389 柜、167MW机架功率;40 万颗 GPU 约对应5,556 柜、667MW;如果把现有 10 万和下一阶段 40 万简单相加,50 万颗 GPU 对应约 6,944 个等效 NVL72 机架,机架设计功率约 833MW。
这不是对未来站点实际功耗的预测。40 万颗 GPU 的具体型号尚未披露,后续也可能包含 GB300 或其他平台。但机械换算已经足以展示数量级:几十万颗 GPU 对应的是数百兆瓦级的机架负载。
而机架功率并不等于整个数据中心的电力需求。园区还需要配电、冷却、网络、存储以及其他辅助系统。因此,GPU 数量继续增加以后,部署约束会自然向外传导。
六、十万卡以后,AI CapEx 开始沿着 GPU 向外扩散
NVIDIA 依然掌握最核心的价值量。GB200 NVL72 本身已经把 Blackwell GPU、Grace CPU、NVLink、NVSwitch 以及液冷机架组织成完整系统;跨机架层面,NVIDIA 还拥有 ConnectX、Spectrum-X 和 InfiniBand 等产品。相比过去单纯统计 GPU 数量,rack-scale 架构意味着GPU 增长与每颗 GPU 对应的系统级价值量同步增加。
网络是第二层。OpenAI 已经明确把 Broadcom 硬件用于 MRC 训练环境。十万卡同步训练对尾部延迟、故障恢复和网络路径的要求提高后,交换芯片、网卡和交换机的经济价值来自一个很直接的逻辑:它们决定昂贵 GPU 的有效利用率。
再往外是电力和液冷。GB200 NVL72 设计功率已经达到约 120kW/柜;Microsoft 披露 Fairwater 的高密度机架可以达到约 140kW,并依赖设施级闭环液冷。资本开支链最终会落到几个可以持续跟踪的指标:GPU 交付量、网络端口与交换容量、单柜功率密度、数据中心新增兆瓦数,以及液冷和电力设备的实际交付周期。
七、Astra 留下的核心信号,是 Scaling 仍然在消耗更大的基础设施
从产业链角度,更值得记录的是一件事:OpenAI 已经完成了一次超过 10 万颗 GPU 的真实预训练任务。这意味着十万卡集群已经从行业路线图进入模型训练现场。
与此同时,MRC 在解决 10 万卡网络问题,Fairwater 在解决数十万卡和跨站点问题,Abilene 正在把大规模 GPU、电力和液冷转化成实际训练资源。
如果下一批 40 万颗 GPU 陆续上线,AI 基础设施投资的观察框架也需要跟着改变。只盯 GPU 出货已经不够。下一轮需要一起跟踪的是:每颗 GPU 背后需要多少网络、电力、液冷和数据中心资产,以及这些基础设施能否跟上 GPU 的交付节奏。
资料来源:OpenAI、NVIDIA、Microsoft、Oracle 公开资料;Jensen Huang X 公开帖文。文中机架与功率换算仅用于量级分析。仅供学习参考,不构成投资建议。


本文版权归属于原作者/机构。
以上内容仅代表作者个人观点,不代表平台立场。本内容仅供投资参考,不应被视为投资建议。如您对平台提供的内容服务有任何疑问或建议,请联系我们。