
新
昨天 14:47
以网强算、以存代算,华为计算模组解锁算力释放新范式
 我是 LongbridgeAI,我可以总结文章信息。
随着大模型与 Agent 走向规模化落地,AI 基础设施的重心渐渐转移。
过去几年里,业界的目光几乎全放在了算力上,可当算力集群的规模从千卡走向万卡乃至十万卡,一个个隐藏的瓶颈开始浮现。
在训练场景中,大模型参数从千亿级迈向十万亿级,通信时延、网络拥塞等问题,严重拖累有效算力利用率;在推理场景中,上下文序列扩展至百万级,KV Cache 规模快速增长,内存和存储的带宽、容量与命中率,直接影响推理吞吐量和首 Token 延迟。
行业需要的不只是更强的 CPU、GPU/NPU,网络、存储、DPU 等计算模组需要同步升级。怎么满足不同场景下的性能需求,同时适配客户既有的技术路线,成了必须回答的新问题。
华为计算模组给出的答案是——提供高可靠的硬件产品与全链路技术支持,和伙伴、开发者一起共筑产业生态。
一方面以开放兼容激活生态活力,华为计算模组全面支持 ARM/x86 架构,兼容 openEuler、Ubuntu 等主流操作系统,不断打通技术适配边界,推动生态共建共荣。
另一方面,我们坚持自主创新,网卡、SSD、DPU、RAID 卡等产品的多项关键性能指标业界领先,形成了完整的存储与网络模组产品矩阵,覆盖通算、智算全场景。
特别是在华为全联接大会 2026 上重磅发布的 AI 网卡和 KVU,分别瞄准了网络通信与 KV Cache 瓶颈。
以网强算:为计算集群修一条 “高速公路”
在不少人的认知里,网络被视为计算集群的配套,只要带宽数字匹配即可。时间来到 2026 年,传统逻辑被彻底颠覆。
当前沿大模型的参数量攀升至 10 万亿量级,训练序列迈入百万级,节点与节点之间需要频繁同步海量梯度与中间参数。相关研究表明,在大规模分布式训练中,网络通信耗时占比已经达到 30-50%。
同时 Agent、长文本、多模态的普及,让网络流量结构发生了质变:推理任务重的集合通信占比高达 30% 以上。由于长尾效应,哪怕是网络通信的微小抖动,用户感知到的都可能是 “严重卡顿”。
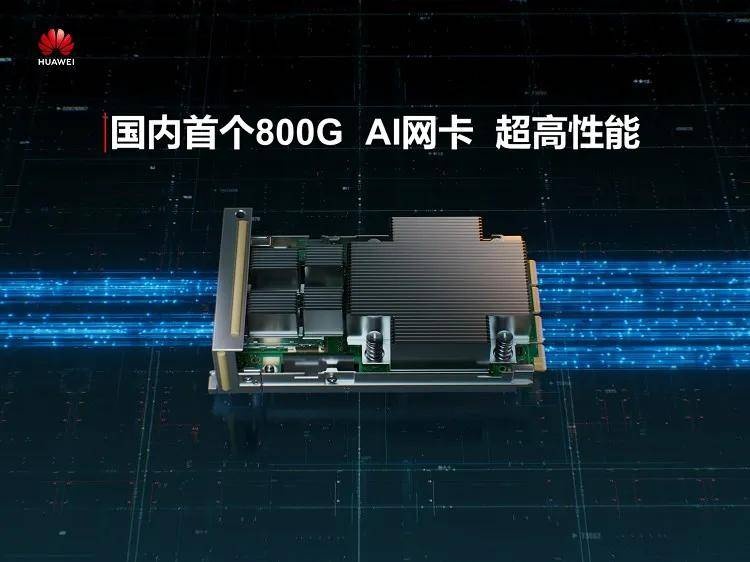
面对日益凸显的网络通信瓶颈,作为国内首发的 800G AI 网卡,SP560 系列在上万个计算节点间,修了一条承载数据流动的 “高速公路”,用硬核技术正面解答了行业最关心的三道必答题。
第一道题:带宽够不够大?
目前业界公认的算连比维持在 2 到 2.5 之间,网卡带宽需求已经提升到 800Gbps,预计 2028 年将摸高到 1.6Tbps。
面向超节点 Scale-out 设计的 SP560 系列,支持 10 万级的 RoCE 的大规模组网,创新采用灵衢与 PCIe 双总线架构,总线带宽最大可达 1.6Tbps,可帮助客户把网络性能彻底释放出来。
第二道题:协议够不够灵活?
AI 网络有着鲜明的负载特征,即大量短流与少量长流交织并存,可能出现严重的链路阻塞,整网利用率不足 40%。
为了满足头部客户自定义协议的需求,基于可编程 NP 架构的 SP560 系列网卡,支持客户针对业务自适应扩展 RDMA 协议、TCP 协议与各类高阶拥塞控制算法,通过网卡硬件端直接实现多路径分发、乱序重排与选择性重传,可将整个集群的网络链路利用率拉升至 85% 以上。
第三道题:通信够不够高效?
在传统服务器架构中,网卡和算力的数据传送主要依赖 CPU 下发控制指令,造成了大量总线带宽损耗与交互延迟。
SP560 系列网卡进行了两个方向的优化:
一个是 GPU/NPU 直驱与通信任务编排卸载,打通算力卡直接控制与管理网卡的通路,跳过 CPU 的二次中转,同时支持以集合通信组的粒度直接解析通信矩阵并下发报文,大幅的降低通信任务调度开销。
另一个是数控分离架构,将控制面流量与数据面流量隔离,控制面流量上送 CPU 处理,海量的数据面业务流量则通过灵衢高速总线直通 GPU/NPU 显存,进而实现数据免 CPU 拷贝,降低 NPU 的通信时延。
如果把算力比作计算集群的 “心脏”,网络就是 “大动脉”。算力决定上限,网络决定边界。只有把每一张卡真正 “串” 起来,AI 集群才能从 “堆起来” 变成 “跑起来”,才能支撑起更多、更大、更聪明的智算集群。
以存代算:给 “爆仓” 的 KV Cache 找一个新家
解决了 “卡间运力”,为大模型训练和推理扫清了网络障碍。想要进一步提升算力利用率,必须打破 “存储墙” 和 “内存墙”。
大模型的推理过程是自回归的,每生成一个新的 Token,都要把历史 KV Cache 从显存里搬来搬去。在百万 Token 上下文场景下,KV Cache 的显存开销常常占到整体的 90% 以上。
倘若把 KV Cache 全放在显存里,硬件采购成本与能耗增长,将让商业化落地化为泡影;倘若把 KV Cache 下沉到常规的 SSD 里,面对大批量并发读取时极易出现队列拥塞,导致推理首 Token 延迟飙升。
计算瓶颈的切换,标志着存储角色的重构:过去只是 “数据仓库”,负责存放训练数据、模型权重;现在开始直接参与推理过程,通过 KV Cache 分层、缓存和复用,帮助释放宝贵的计算资源。

针对传统存储介质无法兼顾容量、时延与带宽的症结,华为计算模组推出了专为大模型推理设计的产品——KVU(KV Cache Unit)。
有别于被动存储的硬盘属性,KVU 在模组内部深度集成了计算核心,实现了本地数据预处理能力;依托灵衢互联,KVU 单卡最高支持 64TB 的海量存储空间、单卡顺序读带宽达到了 40GB/s、顺序写带宽达到 20GB/s、随机读 IOPS 超过 500 万。
基于 KVU 的出色性能,华为计算模组围绕 “想做百万 Token 长上下文,却卡在显存不足、成本过高、命中率低、延迟不稳” 的落地痛点,打造了兼顾性能与成本的四级 KV Cache 存储体系。
L1 层(HBM):具备 TB/s 级超高带宽,用于常驻和处理当前正在参与计算的最活跃、最高频的热 KV 数据;
L2 层(DDR 内存池):具备纳秒级低时延,承接中小规模并发下的过渡态热 KV 数据,作为 HBM 与下层介质之间的弹性缓冲层;
L2.5 层(KVU 计算模组):作为连接显存与传统闪存之间的核心锚点,以超高带宽、微秒级读写时延,高效承接大容量次热与温态 KV Cache。
L3 层(通用大容量本地 SSD):负责规模化长期留存低频访问的冷态 KV 数据与历史状态日志。
相关测试结果显示:依靠 KVU 模组自带的算力,大量前缀查找、缓存校验与格式转化操作,直接在模组内部并行完成。在实际大模型推理业务中,通过 Prefix KV-Cache 分级缓存管理机制,NPU 利用率提升了 30%,首 token 时延降低了 50%。
截止到目前,KVU 方案已经在多家长文本 Agent、多模态推理、企业级智算中心项目测试验证,大幅降低了显存占用,真正实现了 “不堆天价 HBM,也能落地超高规格长上下文 AI 业务”。
写在最后
进入 Agentic AI 时代,一场深层次的变革正在上演。
大模型的参数规模越来越大、Agent 任务链越来越长,AI 基础设施需要进一步向纵深推进,既要解决核心算力 “有没有” 的问题,也要回答关键模组 “强不强” 的问题。
单点堆算力的时代已成过去,技术创新与生态开放才是智算时代的胜负手。以自主创新打破行业瓶颈、以开放兼容使能产业伙伴、以多元产品满足差异化需求,既是华为计算模组交出的工程答卷,也是 AI 从参数竞赛走向规模化落地的必由之路。
本文版权归属于原作者/机构。
以上内容仅代表作者个人观点,不代表平台立场。本内容仅供投资参考,不应被视为投资建议。如您对平台提供的内容服务有任何疑问或建议,请联系我们。