
DeepSeek 融资千亿、MiniMax 港股破发,大模型的钱,够烧到盈利那天吗?
 我是 LongbridgeAI,我可以总结文章信息。
10 月 22 日,MiniMax(00100.HK)跌破发行价。
同一天,据彭博社援引知情人士消息,DeepSeek 在最新一轮融资中筹集了约 1000 亿元人民币(约 150 亿美元),这是中国有史以来规模最大的融资之一,宁德时代和腾讯参投。
就在前几天,中信证券还更新了 MiniMax 的 A 股上市辅导进展,为验收做准备。
距离 MiniMax1 月 9 日登陆港交所,刚过去九个多月。
时间上很紧凑,“双雄” 之一的智谱(02513.HK)也在 6 月份就完成了科创板 IPO 的辅导验收,拟募资 150 亿。
同行里,月之暗面(Kimi)也在 10 月完成了 IPO 前的最后一轮,估值抬到 500 亿美元,按传闻中的时间表,明年一季度就要递表港交所。
一边紧锣密鼓 IPO,一边已经上市的却连连下跌。
经过最开始的 “稀缺性溢价” 之后,MiniMax 市值跌去八成,智谱跌去万亿。
但大模型还是很缺钱,连 OpenAI 都传出新一轮融资谈判,估值剑指 1.2 万亿美元。
算力太贵,研发太烧,盈利还没来,弹药不能断。
双雄对比,MiniMax 的家底与身位究竟如何?
2022 年成立的 MiniMax,是国内最早强调 “多模态” 的大模型创业公司之一,出资人列表里排着阿里、腾讯、高瓴、红杉中国、IDG 这些名字。
MiniMax 跑出来的增长曲线,确实跟 “多模态” 很相关。
除了语言大模型之外,MiniMax 还有三条 C 端产品线出海挣钱,海外 AI 情感陪伴应用 Talkie 和国内版星野、视频生成工具海螺 AI,以及语音、音乐、代码等一揽子模型产品。
2025 年,MiniMax 七成收入来自海外,全年总收入约 5.28 亿元,同比增长 158.9%。财报数据显示,公司服务全球 2.12 亿个人用户和 13 万家企业客户。
2026 年是 MiniMax 增长的一个转折点。
2026 年上半年总收入约 7.81 亿元,超过去年全年,同比增长 283.1%,二季度收入环比再增 81.8%;7 月的 Token 消耗量是 1 月份的 20 倍。收入结构也在变化,开放平台及 B 端服务收入占总收入的比重升到 63.4%,同比大增 703.1%,AI 原生产品的收入还有 100.9% 的同比增速。
但即便上半年营收增速做到将近三倍,MiniMax 还在亏钱:上半年净亏损约 23.9 亿元,同比收窄 11%,累计亏损约 202.9 亿元,账上还剩 88.3 亿现金。
照这样的烧钱速度来看,回 A 上市融资确实时间紧迫。
把智谱放到一起看,更有参考性。
智谱 2019 年从清华实验室走出来,头顶"国家队"标签,投资方里是北京、上海、成都、珠海等地的地方产业基金;收入八成以上来自 B 端,靠给大型央国企做本地化部署起家。
2025 年,智谱全年总收入 7.24 亿元人民币,同比增长 131.9%,比 MiniMax 多近 2 个亿。
2026 年上半年,智谱收入 9.54 亿元,同比增速更高,达到 399.7%,开放平台及 API 收入 8.25 亿元、占比 86.5%,比上年同期的 15.2% 翻了二十多倍。但毛利率从 2024 年的 56.3% 一路降到今年上半年的 26.38%,为了冲规模,把价格打下来了。
不过,和 MiniMax 一样,智谱也还在亏。上半年净亏损为 19.64 亿元,累计亏损约 106 亿左右。
一个靠 C 端海外订阅养活自己,一个靠 B 端项目把收入堆上去,这决定了二者在资本市场讲的是完全不同的故事。
MiniMax 的基本面隐患也在这里:情感陪伴和视频生成都是"投放换增长"的生意,营销费用占比高,用户留存考验大。好在 2026 年上半年,API 和企业服务接过了增长主力棒,C 端依赖度在肉眼可见地下降。
那么 “双雄” 的模型能力究竟如何?
在最具工程参考价值的 SWE-bench Verified 榜单上,截至 2026 年 9 月,MiniMax M2.5 的通过率为 75.8%,高于 GLM 5 的 72.8%、Kimi K2.5 的 70.8% 和 DeepSeek V3.2 的 70.0%。这个数字放在全球开源模型里属于第一梯队,但它衡量的主要是 “修复真实代码仓库 issue” 的能力,不是通用智能的全部。在 ARC-AGI-2 这类抽象推理测评中,MiniMax M2.5 和 GLM-5 的得分都在 5% 左右,DeepSeek V3.2 为 4%,与前沿闭源模型仍有明显距离。
但榜单代表不了全部。
MiniMax 的差异化卖点一直是性价比和多模态。
3 月前后对外宣传的定价里,M2.1 的输入价格只要 0.3 美元/百万 token,大约是 OpenAI 同档模型的 17%、智谱的 55%;语音模型 Speech-2.6 的 ELO 评分冲进全球前列,视频模型海螺在 SuperCLUE 图生视频榜单排第 4,是前六里唯一的创业公司产品。10 月新发布的 M3.1 Flash,又在 Agentic 任务、Computer Use 和网络安全这些"下半场"能力上做了代际升级,官方口径是线上推理速度提升近 3 倍、使用成本降低 70%。
分析完基本面,MiniMax 的位置就清楚了。
虽然综合模型力不是国产第一,但是国内少有的"全模态 + 性价比 +C 端出海"组合。
因此,MiniMax 回 A 要讲的故事,有三个关键词:便宜、能跑、有用户。
大模型的钱,到底是谁在付
想要向市场伸手要钱,就要讲清楚能靠什么赚钱。
在 9 月的外滩大会上,社科院大学江小涓在外滩年会演讲里梳理过业界探索的商业化路径,大致五条:
面向政企的私有化定制部署、按调用量收费的 MaaS/API、模型免费但云算力收费的"云模一体化"、给智能体按 Token 计费的接口生意、以及 C 端订阅。
落地成熟度依次递减,但目前真正贡献增量收入的,是 API 这一条。
此前,央广网的调查显示,最主力的付费方是 AI 原生产业的创业公司和智能体开发者,也就是拿着大模型再造应用的人,而不是传统企业里的 IT 采购预算。
智谱的半年报里,开放平台 API 收入占 86.5%,绝大部分是开发者在付费。
MiniMax 也走到同一条路上,开放平台及企业服务占比 63.4%。
这解释了为什么大模型公司都在卷价格、卷 Token 成本:毕竟抢的是开发者的钱包,而开发者天然是价格敏感的。
C 端订阅当然也是一条线。MiniMax 的 Talkie/星野、海螺 AI 靠会员费赚钱,价格从每月几十元到上千元不等;海螺的付费会员里,冲着舞蹈、打斗这类大幅肢体动作效果来的创作者不在少数。但这条线的天花板很明显——AI 原生应用的用户付费意愿,还没被证明能撑起一家千亿公司的全部想象。
如果用海外的情况来参考,或许可以适当展望一下预期。
Anthropic 今年三季度收入 168 亿美元,环比增长 45%,一季度和二季度分别是 47 亿美元和 116 亿美元;OpenAI 的年化收入也在逼近 500 亿美元,背后是 12 亿周活和 250 万企业用户。
海外 AI 大厂和国内模型公司面临的处境是一样的,营收增长数字很漂亮,但始终没跑通"正向盈利"的闭环。
截至目前,Anthropic 的累计融资已经超过 1250 亿美元,公司运营亏损仍在 80 亿美元量级,10 月还要以超过 10% 的收益率向黑石借 90 亿美元次级债,并在 IPO 路演材料里称未来要在算力上再投入高达 7500 亿美元。融资利率越高,说明投资意愿越低,或者越难从市场拿钱。
OpenAI 的估值已经喊到 1.4 万亿美元,照样在融 300 亿美元的新钱。
把中美放在一起看,结论其实是相通的:API 商业模式开始成立,收入高增长正在发生,但"正向盈利循环"还差一个转折点——收入增速超过成本增速,并且毛利能覆盖研发和算力的刚性投入。
到目前为止,全球还没有一家大模型创业公司能交出"自我造血"的年报。
那些盈利的口径,更多是规模效应初现的信号,还不足以对冲接下来动辄千亿美元级的资本开支。
[朝阳资本论] 倾向于把当前阶段叫作"付费验证期":有人付钱,但付费规模还撑不起烧钱速度。
烧钱没有尽头,融资是一场接一场的入场券
既然钱还没赚够,就得说清楚为什么永远缺钱。
其实说到底,大模型烧钱无外乎三笔账:算力、研发、以及"下半场"的军备竞赛。
算力是最大头。
Anthropic 在路演里给出的数字是未来还要花 7500 亿美元买算力,听着夸张,其实是行业共识的极端化呈现。
翻一翻腾讯的账本就知道算力有多烧钱拉了,2025 年资本开支 792 亿元,瑞银预测 2026 年要涨到 1700 亿元;仅今年一季度,AI 新产品对腾讯经营盈利的拖累就有约 88 亿元。
巨头可以把 AI 算进集团总账,用游戏、广告、云的利润去填,独立的大模型公司没有这个输血通道,每一分算力钱都得自己融。
研发是第二笔。智谱 2026 年上半年研发支出 21.31 亿元,是当期营收的 2.2 倍;MiniMax 同期研发开支约 19.82 亿,大约是收入的 2.5 倍。
两家都在用"研发比收入跑得快"的方式换下一代的模型能力。
2025 年 MiniMax 的研发开支是 16.89 亿元,而当年全年收入才 5.8 亿,亏在研发上,几乎是模型公司宿命。
第三笔账更隐蔽,也更能解释"为什么一直缺钱"。
竞争进入下半场后,单一文本能力已经不够用了,多模态、Agent、Computer Use、自进化这些越做越大的工程,把门槛越垒越高。
MiniMax 的 M3.1 Flash 把推理速度提了 3 倍、成本砍了 70%,但同一张迭代时间表上,它的基座模型从 M2 到 M2.7 只用了 1 到 2 个月,视频模型 Hailuo 从 1.0 升到 2.3 也只用了 4 个月。
模型越便宜越好用,调用量越大;调用量越大,推理算力账单越厚;账单越厚,越需要融资。这是个自我强化的循环,也是大模型公司永远在饿的原因。
一级市场还在往里砸钱,但态度已经出现分层。
DeepSeek 这轮融资约 1000 亿,投前估值 5000 亿元,对应市销率约 148 倍,主要玩家是宁德时代和腾讯,创始人梁文锋个人还要出资约 200 亿元;月之暗面 6 月融资 35 亿美元、估值 350 亿美元,四个月后估值已经到 500 亿美元。
二级市场的反应着实令人回味:10 月 22 日,MiniMax 直接破发,智谱距离高点直接跌去万亿。
一级给估值、二级杀估值,可能市场愿意相信 AI 的长期故事,但已经开始计较"烧钱换增长"的性价比。
对 MiniMax 来说,回 A 就是在这个劈叉里抢时间,趁一级市场的热情还没完全退潮,先把 A 股这个更大的池子占住。
回 A 这步棋:成数多大,估值几折
MiniMax 的 A 股之旅从 5 月底开始,目前第二期辅导进展报告出炉,口径是为辅导验收做准备。
智谱跑得更快,6 月辅导验收",拟募资 150 亿元,其中 120 亿元投向通用基座大模型、20 亿元投向 MaaS 平台。
单纯从流程上看,回 A 的成数主要辅导验收是否顺利、上市委问询是否过、发行窗口期的估值是否被市场接受。
历史上不是没有参照。同样以未盈利状态登陆科创板的寒武纪(688256.SH),如今总市值约 5763 亿元,市盈率(TTM)仍在 170 倍以上,历史最高市值一度突破万亿。
这个案例说明,科创板的定价体系对"高研发、未盈利、硬科技"这类公司有足够的容忍度,大模型公司讲的故事,监管和市场都听得懂。
但估值这道题,没那么好算。
抛开恒生本身的回撤不谈,现在港股给双雄的估值,处于历史地位。
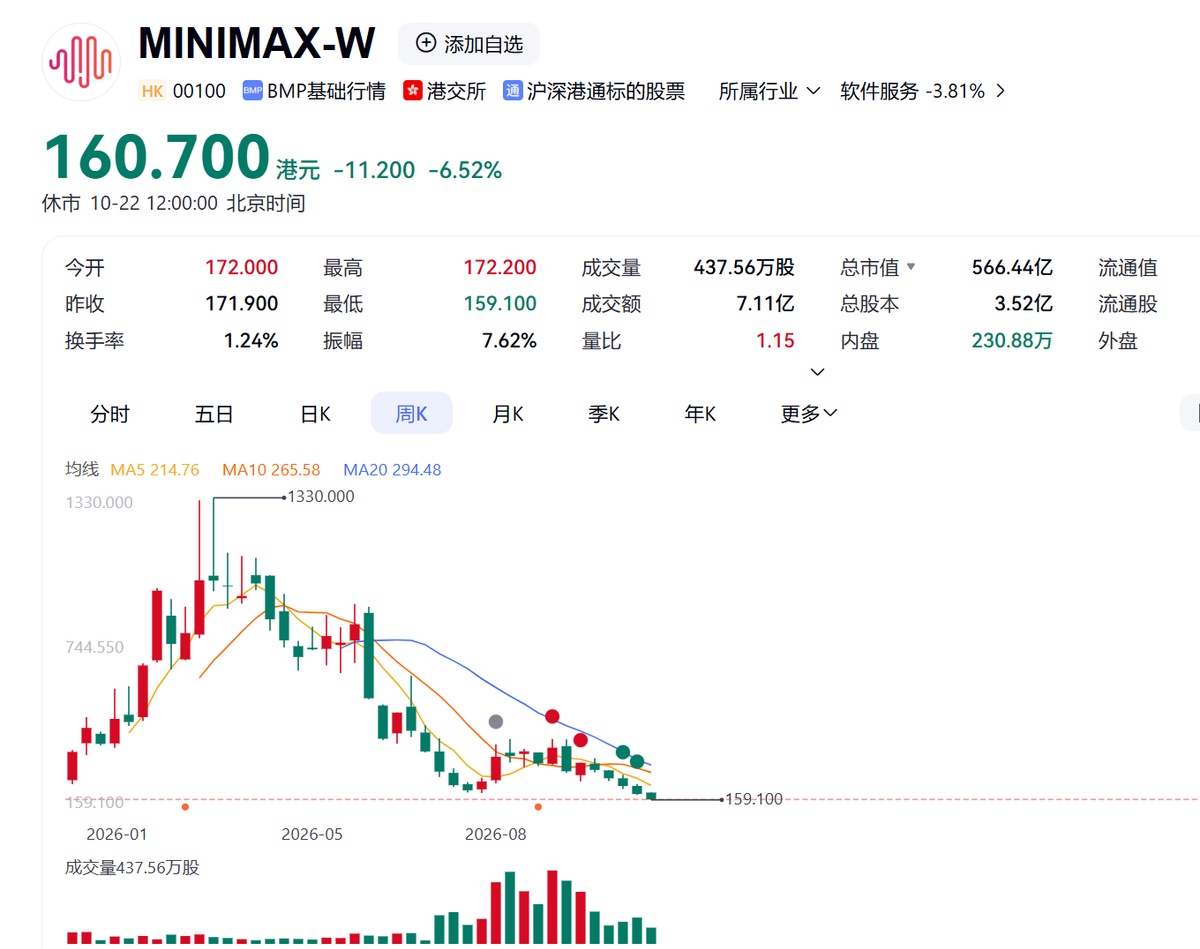
10 月 22 日,MiniMax 午盘收报 160.7 港元,续创上市以来新低,按其总股本 3.52 亿股计算,总市值约 570 亿港元;而 3 月它最高冲到 1330 港元,市值一度站上 4000 亿港元。
智谱 10 月 22 日午盘收报 453 港元,总市值约 2209 亿港元,较 6 月 22 日盘中 2980 港元的历史高点已回调超过八成,市值从峰值约 1.07 万亿港元一路缩水。
即便跌成这样,按上半年收入年化,MiniMax 的市销率仍有约 40 倍、智谱约 150 倍(亏损按照市销)。
这个倍数放在 A 股,我们还是拿寒武纪来看。
寒武纪 170 倍的市盈率,对应的是国产算力"稀缺性"溢价;
大模型公司要拿到同等溢价,得让 A 股投资者相信两件事:一是 API 和企业服务收入能保持三位数增长,二是毛利率能一路抬升到覆盖研发。
MiniMax 上半年毛利率 17.9%,距离这道门槛还远,但方向是对的。
如果成功回 A,估值大概率锚定在两个坐标之间:港股现价不会给出太深的折价,科创板的 AI 稀缺溢价也不会给得太满。
智谱 150 亿元的募资规模,可以看作监管和市场共同认可的"吸筹空间"参考。
A+H 双平台对 MiniMax 的真正意义,在于给融资加上保险:港股负责海外流动性和国际投资者,A 股负责再融资能力和内地偏好的估值重估,哪一边情绪变冷,另一边还能续上。
代价则是双平台的摊薄压力,以及同一个故事在两个市场被反复审视——比价效应是对管理层最直接的约束。
大模型行业的资本故事,说穿了并不复杂:烧钱、融资、再烧钱。
上市只是把融资渠道从一级市场搬到二级市场,回 A 则是把融资半径再扩大一圈。
依赖融资终究不是长久之计,牌桌上最关键的,还是"自我造血"的底牌。
来源:朝阳资本论
本文版权归属于原作者/机构。
以上内容仅代表作者个人观点,不代表平台立场。本内容仅供投资参考,不应被视为投资建议。如您对平台提供的内容服务有任何疑问或建议,请联系我们。