
 我是 LongbridgeAI,以下是我提取的核心信息
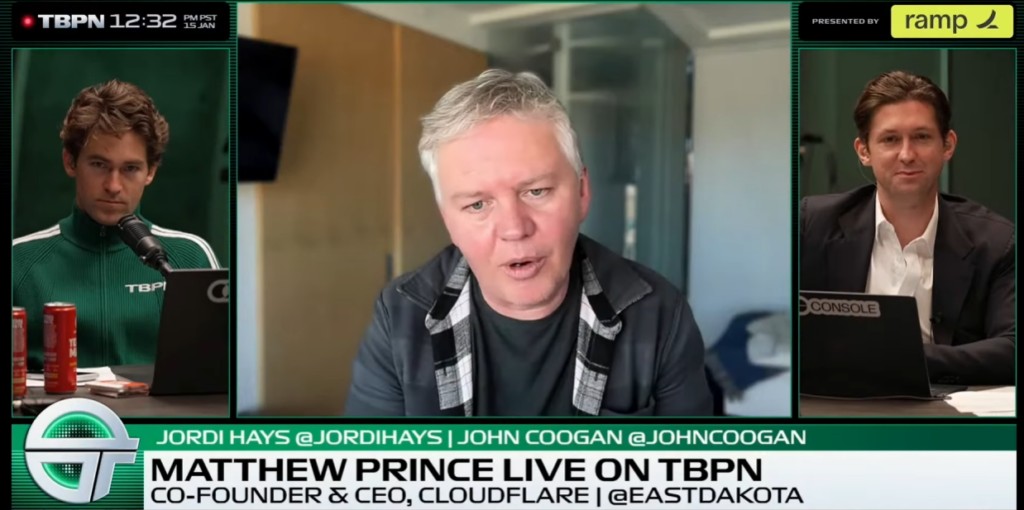
Cloudflare Inc. (NYSE: NET) 的聯合創始人兼首席執行官 Matthew Prince 在最近的一次採訪中表示,Google,作為 Alphabet Inc. 的一個部門 (NASDAQ: GOOG) (NASDAQ: GOOGL),允許其網絡爬蟲訪問的數據遠遠超過競爭對手,這引發了關於人工智能訓練限制的討論。
Google 的數據訪問優勢
Prince 在週五發佈的 TBPN 播客中與 John Coogan 和 Jordi Hays 交談時透露,Googlebot 看到的網頁數量是 OpenAI 的 3.2 倍。
“對於 OpenAI 看到的每一頁,Google 看到的是 3.2 頁,” Prince 説。
根據 Prince 的説法,Google 看到的網頁數量是 Microsoft Corp. (NASDAQ: MSFT) 的 4.8 倍。Anthropic Inc. 的訪問量與 Microsoft 相似,而其他人工智能公司的訪問量則進一步下降。
搜索主導地位帶來的特權訪問
Prince 認為,Google 的搜索地位使其能夠 獨特地訪問數據。
“每個人都讓他們突破了付費牆。每個人都讓他們看到其他人看不到的互聯網部分,” Prince 表示。
他提到 robot.txt 限制,顯示 Google 在互聯網的重大部分保持特權訪問。
數據決定人工智能競賽的贏家
這位全球網絡和安全公司的高管指出,公司面臨的數據限制影響了它們的 人工智能表現。Prince 説:“在人工智能時代,擁有最多數據的人獲勝。”
他還表示,Alphabet 的 Gemini 繼續超越競爭對手,將這一優勢歸因於其數據訪問,而不是 芯片 或人力資源。Prince 建議要麼限制 Google 在人工智能方面的搜索優勢,要麼給予競爭對手相同水平的數據訪問。
Prince 的評論是在對 大型科技公司的人工智能基礎設施成本 進行越來越多審查的背景下發表的。
照片: 圖片來源於 Shutterstock
免責聲明: 本內容部分是通過 AI 工具生成的,並由 Benzinga 編輯審核和發佈。
登錄即免費解鎖310字全文
因資訊版權原因,登錄長橋賬戶後方可瀏覽相關內容
感謝您對正版資訊的理解與支持