
 我是 LongbridgeAI,我可以總結文章信息。
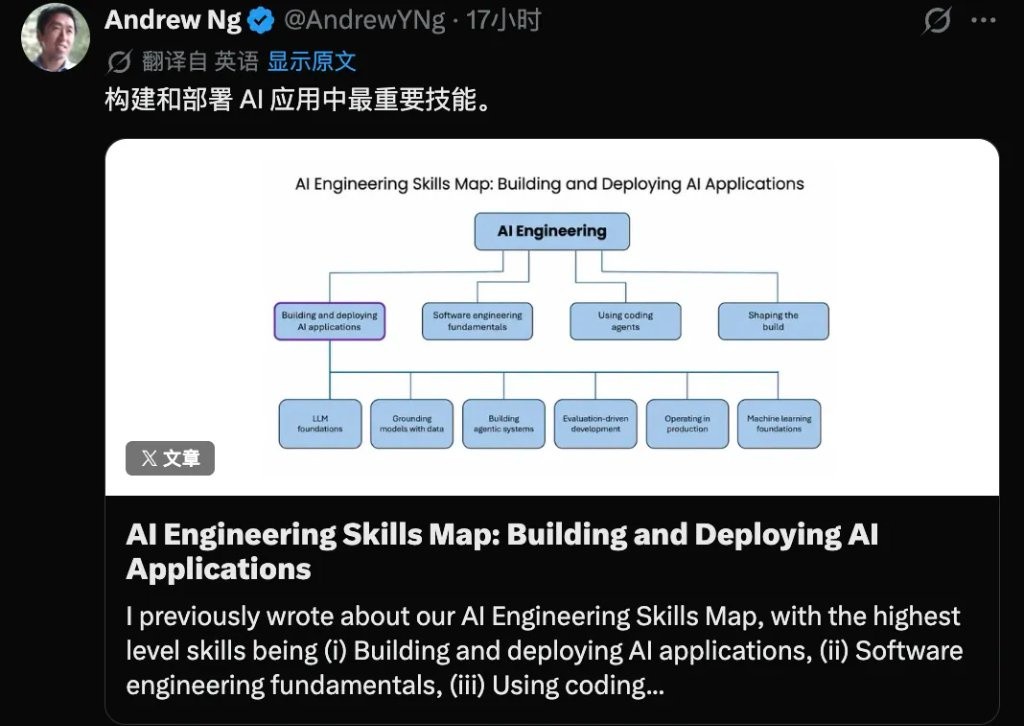
吳恩達發佈文章拆解 AI 工程師核心能力,指出需掌握六大關鍵領域:LLM 基礎、數據構建、智能體系統搭建、評估驅動開發、生產運維及機器學習基礎。他強調 AI 應用與傳統軟件的根本差異在於輸出的不確定性,要求工程師深入理解 LLM 底層機制以應對開發中的迭代與決策挑戰。
吳恩達老師剛剛發了一篇文章,專門拆解 AI 工程師的核心能力。
他研究了大量招聘信息,做了系統的專家訪談和問卷調查,最終把「會做 AI 應用」這件事拆成了 6 塊。
這 6 塊能力分別是:LLM 基礎、用數據給模型打地基、搭建智能體系統、以評估驅動開發、生產環境運維,以及機器學習基礎。
聽起來像是目錄,但每一塊展開,都有東西。
AI 應用和普通軟件,差在哪?
先説一個根本性的差異。
傳統軟件,輸入確定,輸出確定。你寫一個排序函數,跑一萬次結果都一樣。
AI 應用不是這樣的。LLM 會輸出什麼,你事先不知道。模型會犯什麼錯,你也不知道。這種不確定性,讓整個開發過程必須反覆迭代——寫一版,看看效果,再決定下一步怎麼改。
所以 AI 工程師的核心能力,本質上是在不確定中做決策的能力。
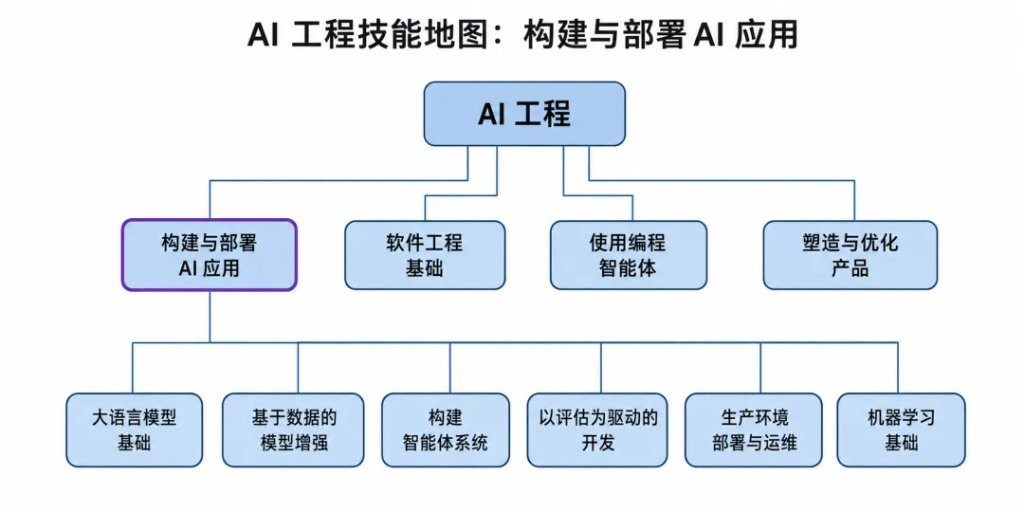
第一塊:搞懂 LLM 的底層
很多人用 LLM,就像用一個黑箱,扔進去一個問題,等答案出來,然後不知道為什麼它答對了,也不知道為什麼它答錯了。
吳恩達認為,這不夠。
你要理解 LLM 怎麼把文本切成 token,怎麼逐步生成輸出。這樣你才能判斷:這個任務它能幹好嗎?在什麼情況下它容易出錯?
除此之外,還有一堆工程細節需要掌握:什麼時候用多模態模型,怎麼在有限的上下文窗口裏做取捨,緩存怎麼算,模型的知識截止到哪裏,推理的算力怎麼控制,工具調用什麼時候用。
再往深走,還有一個問題:什麼時候需要微調模型,什麼時候考慮自己部署。
這些事,理解了底層才能做出對的判斷。
第二塊:給模型喂對數據
LLM 的輸出質量,很大程度取決於它的輸入。
早期流行的做法是 RAG,用向量搜索把相關內容塞進上下文裏。但現在,這套玩法已經遠不止於此。
你需要判斷:哪些內容應該直接寫進 prompt,哪些讓模型在用的時候自己用工具去查?
數據的組織方式怎麼選?向量索引、知識圖譜、結構化數據上的語義層,各自適合什麼場景?
文檔要怎麼處理才能讓模型讀得懂,PDF、HTML、圖片,不同格式的處理方式不一樣。
還有一件容易被忽視的事:數據的質量要持續維護,不能一次性處理完就不管了。
第三塊:搭智能體,有講究
智能體系統的形態,差異很大。
簡單的是固定工作流:預先設計好一系列 LLM 調用步驟,一步接一步執行。複雜的是讓 LLM 自己判斷下一步,循環決策直到任務完成。
怎麼選?吳恩達給了幾個判斷維度:
哪些步驟可以並行跑,哪些必須串行?什麼地方用代碼更可靠,什麼地方用 LLM 更靈活?出錯了怎麼回退?
工具調用方面,模型能用哪些工具、能執行什麼命令,都需要設計。記憶怎麼管理——特別是會話很長的時候,上下文放不下,怎麼辦?什麼時候需要多個智能體協作而不是一個智能體搞定所有事?
還有一件很重要的事,往往被跳過:原型跑通了,怎麼讓它變成可以放進生產環境的可靠系統?這需要考慮安全邊界、對抗性輸入,以及防止數據泄露之類的風險。
第四塊:用評估驅動開發,這是真正的分水嶺
這一塊,吳恩達説:
在他見過的 AI 工程師裏,能夠跑通一套嚴格的評估閉環,是區分優秀和普通的最關鍵特質。
什麼意思?
很多人改系統靠感覺,覺得哪裏不對就改哪裏,改完憑主觀判斷「好像好了一點」。
厲害的工程師是另一種做法:先把要衡量什麼想清楚,再建立一套評估機制,每次改動之後跑評估,根據數據決定下一步改什麼。
評估本身也是技術活。你要分析系統的輸出和中間過程,結合業務目標確定衡量指標。評估的形式也有很多:代碼寫死的規則、用 LLM 來打分、讓人來判斷。這三種各自適合什麼場景,本身就需要判斷力。
而且評估也不是一次性的,它要跟着系統迭代一起演進。
第五塊:生產環境,另一個世界
把系統做出來是一回事,在生產環境裏跑起來是另一回事。
AI 應用的運維,和傳統軟件的運維有幾個關鍵差異。
第一是觀測。你需要知道系統在真實用户身上的表現,而不只是測試集上的表現。性能要監控,數據分佈的漂移要發現,模型突然變差或者被攻擊注入,要能快速響應。
第二是測試體系。AI 系統的迴歸測試,比傳統軟件複雜——很多結果沒有唯一正確答案,需要統計方法來判斷是不是變好或者變差了。測試的力度,要和出錯的代價匹配。
第三是成本和延遲控制。選哪個模型、要不要蒸餾、工作流能不能簡化,這些決策在用户量上來之後,會直接影響系統能不能活下去。
第六塊:機器學習基礎,繞不開
最後一塊,吳恩達説:
他認識的所有在 LLM 應用上做得好的工程師,都對機器學習和深度學習有一定深度的理解。
為什麼?
因為 LLM 本身就是機器學習的產物,很多判斷需要從 ML 的視角才能做對。而且很多實際應用場景裏,還是需要用到傳統的機器學習——無論是用別人訓練好的模型,還是自己訓練。
更重要的是,機器學習裏有幾個核心概念,對做 AI 應用極其有用:偏差方差的權衡、錯誤分析、數據工程。這些概念提供了一套思維框架,幫你在面對不確定輸出的系統時,做出更好的判斷。
風險提示及免責條款
市場有風險,投資需謹慎。本文不構成個人投資建議,也未考慮到個別用户特殊的投資目標、財務狀況或需要。用户應考慮本文中的任何意見、觀點或結論是否符合其特定狀況。據此投資,責任自負。