
新
昨日 14:47
以網強算、以存代算,華為計算模組解鎖算力釋放新範式
 我是 LongbridgeAI,我可以總結文章信息。
隨着大模型與 Agent 走向規模化落地,AI 基礎設施的重心漸漸轉移。
過去幾年裏,業界的目光幾乎全放在了算力上,可當算力集羣的規模從千卡走向萬卡乃至十萬卡,一個個隱藏的瓶頸開始浮現。
在訓練場景中,大模型參數從千億級邁向十萬億級,通信時延、網絡擁塞等問題,嚴重拖累有效算力利用率;在推理場景中,上下文序列擴展至百萬級,KV Cache 規模快速增長,內存和存儲的帶寬、容量與命中率,直接影響推理吞吐量和首 Token 延遲。
行業需要的不只是更強的 CPU、GPU/NPU,網絡、存儲、DPU 等計算模組需要同步升級。怎麼滿足不同場景下的性能需求,同時適配客户既有的技術路線,成了必須回答的新問題。
華為計算模組給出的答案是——提供高可靠的硬件產品與全鏈路技術支持,和夥伴、開發者一起共築產業生態。
一方面以開放兼容激活生態活力,華為計算模組全面支持 ARM/x86 架構,兼容 openEuler、Ubuntu 等主流操作系統,不斷打通技術適配邊界,推動生態共建共榮。
另一方面,我們堅持自主創新,網卡、SSD、DPU、RAID 卡等產品的多項關鍵性能指標業界領先,形成了完整的存儲與網絡模組產品矩陣,覆蓋通算、智算全場景。
特別是在華為全聯接大會 2026 上重磅發佈的 AI 網卡和 KVU,分別瞄準了網絡通信與 KV Cache 瓶頸。
以網強算:為計算集羣修一條 “高速公路”
在不少人的認知裏,網絡被視為計算集羣的配套,只要帶寬數字匹配即可。時間來到 2026 年,傳統邏輯被徹底顛覆。
當前沿大模型的參數量攀升至 10 萬億量級,訓練序列邁入百萬級,節點與節點之間需要頻繁同步海量梯度與中間參數。相關研究表明,在大規模分佈式訓練中,網絡通信耗時佔比已經達到 30-50%。
同時 Agent、長文本、多模態的普及,讓網絡流量結構發生了質變:推理任務重的集合通信佔比高達 30% 以上。由於長尾效應,哪怕是網絡通信的微小抖動,用户感知到的都可能是 “嚴重卡頓”。
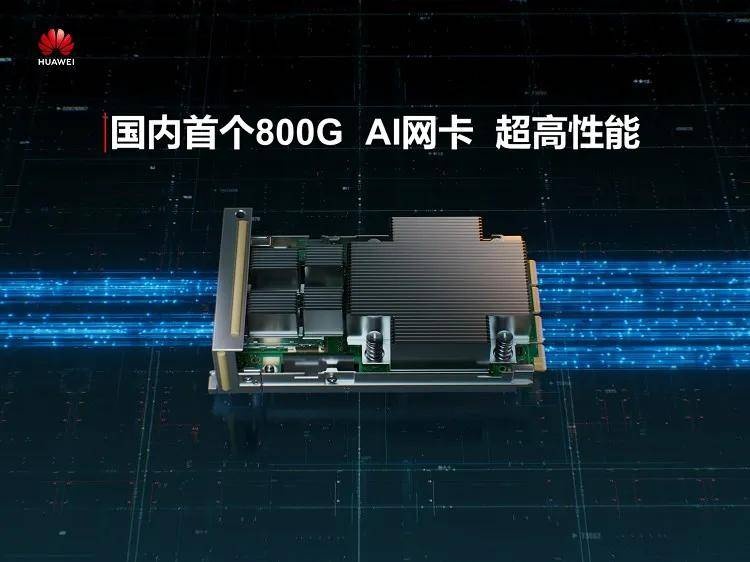
面對日益凸顯的網絡通信瓶頸,作為國內首發的 800G AI 網卡,SP560 系列在上萬個計算節點間,修了一條承載數據流動的 “高速公路”,用硬核技術正面解答了行業最關心的三道必答題。
第一道題:帶寬夠不夠大?
目前業界公認的算連比維持在 2 到 2.5 之間,網卡帶寬需求已經提升到 800Gbps,預計 2028 年將摸高到 1.6Tbps。
面向超節點 Scale-out 設計的 SP560 系列,支持 10 萬級的 RoCE 的大規模組網,創新採用靈衢與 PCIe 雙總線架構,總線帶寬最大可達 1.6Tbps,可幫助客户把網絡性能徹底釋放出來。
第二道題:協議夠不夠靈活?
AI 網絡有着鮮明的負載特徵,即大量短流與少量長流交織並存,可能出現嚴重的鏈路阻塞,整網利用率不足 40%。
為了滿足頭部客户自定義協議的需求,基於可編程 NP 架構的 SP560 系列網卡,支持客户針對業務自適應擴展 RDMA 協議、TCP 協議與各類高階擁塞控制算法,通過網卡硬件端直接實現多路徑分發、亂序重排與選擇性重傳,可將整個集羣的網絡鏈路利用率拉昇至 85% 以上。
第三道題:通信夠不夠高效?
在傳統服務器架構中,網卡和算力的數據傳送主要依賴 CPU 下發控制指令,造成了大量總線帶寬損耗與交互延遲。
SP560 系列網卡進行了兩個方向的優化:
一個是 GPU/NPU 直驅與通信任務編排卸載,打通算力卡直接控制與管理網卡的通路,跳過 CPU 的二次中轉,同時支持以集合通信組的粒度直接解析通信矩陣並下發報文,大幅的降低通信任務調度開銷。
另一個是數控分離架構,將控制面流量與數據面流量隔離,控制面流量上送 CPU 處理,海量的數據面業務流量則通過靈衢高速總線直通 GPU/NPU 顯存,進而實現數據免 CPU 拷貝,降低 NPU 的通信時延。
如果把算力比作計算集羣的 “心臟”,網絡就是 “大動脈”。算力決定上限,網絡決定邊界。只有把每一張卡真正 “串” 起來,AI 集羣才能從 “堆起來” 變成 “跑起來”,才能支撐起更多、更大、更聰明的智算集羣。
以存代算:給 “爆倉” 的 KV Cache 找一個新家
解決了 “卡間運力”,為大模型訓練和推理掃清了網絡障礙。想要進一步提升算力利用率,必須打破 “存儲牆” 和 “內存牆”。
大模型的推理過程是自迴歸的,每生成一個新的 Token,都要把歷史 KV Cache 從顯存裏搬來搬去。在百萬 Token 上下文場景下,KV Cache 的顯存開銷常常佔到整體的 90% 以上。
倘若把 KV Cache 全放在顯存裏,硬件採購成本與能耗增長,將讓商業化落地化為泡影;倘若把 KV Cache 下沉到常規的 SSD 裏,面對大批量併發讀取時極易出現隊列擁塞,導致推理首 Token 延遲飆升。
計算瓶頸的切換,標誌着存儲角色的重構:過去只是 “數據倉庫”,負責存放訓練數據、模型權重;現在開始直接參與推理過程,通過 KV Cache 分層、緩存和複用,幫助釋放寶貴的計算資源。

針對傳統存儲介質無法兼顧容量、時延與帶寬的癥結,華為計算模組推出了專為大模型推理設計的產品——KVU(KV Cache Unit)。
有別於被動存儲的硬盤屬性,KVU 在模組內部深度集成了計算核心,實現了本地數據預處理能力;依託靈衢互聯,KVU 單卡最高支持 64TB 的海量存儲空間、單卡順序讀帶寬達到了 40GB/s、順序寫帶寬達到 20GB/s、隨機讀 IOPS 超過 500 萬。
基於 KVU 的出色性能,華為計算模組圍繞 “想做百萬 Token 長上下文,卻卡在顯存不足、成本過高、命中率低、延遲不穩” 的落地痛點,打造了兼顧性能與成本的四級 KV Cache 存儲體系。
L1 層(HBM):具備 TB/s 級超高帶寬,用於常駐和處理當前正在參與計算的最活躍、最高頻的熱 KV 數據;
L2 層(DDR 內存池):具備納秒級低時延,承接中小規模併發下的過渡態熱 KV 數據,作為 HBM 與下層介質之間的彈性緩衝層;
L2.5 層(KVU 計算模組):作為連接顯存與傳統閃存之間的核心錨點,以超高帶寬、微秒級讀寫時延,高效承接大容量次熱與温態 KV Cache。
L3 層(通用大容量本地 SSD):負責規模化長期留存低頻訪問的冷態 KV 數據與歷史狀態日誌。
相關測試結果顯示:依靠 KVU 模組自帶的算力,大量前綴查找、緩存校驗與格式轉化操作,直接在模組內部並行完成。在實際大模型推理業務中,通過 Prefix KV-Cache 分級緩存管理機制,NPU 利用率提升了 30%,首 token 時延降低了 50%。
截止到目前,KVU 方案已經在多家長文本 Agent、多模態推理、企業級智算中心項目測試驗證,大幅降低了顯存佔用,真正實現了 “不堆天價 HBM,也能落地超高規格長上下文 AI 業務”。
寫在最後
進入 Agentic AI 時代,一場深層次的變革正在上演。
大模型的參數規模越來越大、Agent 任務鏈越來越長,AI 基礎設施需要進一步向縱深推進,既要解決核心算力 “有沒有” 的問題,也要回答關鍵模組 “強不強” 的問題。
單點堆算力的時代已成過去,技術創新與生態開放才是智算時代的勝負手。以自主創新打破行業瓶頸、以開放兼容使能產業夥伴、以多元產品滿足差異化需求,既是華為計算模組交出的工程答卷,也是 AI 從參數競賽走向規模化落地的必由之路。
本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。