
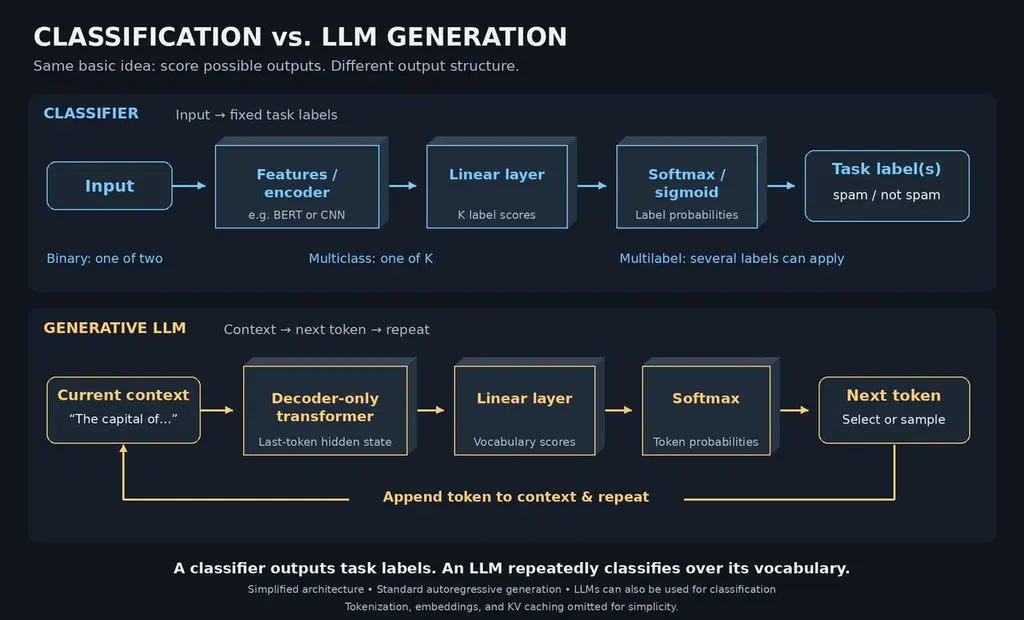
分類器將輸入映射到一組固定的標籤。分類器的主要類型包括:
🟠 二分類:郵件 ∈ {垃圾郵件,非垃圾郵件}🟠 多分類:文本 ∈ {正面,中性,負面}🟠 多標籤分類:電影 ⊆ {動作,恐怖,喜劇,愛情,奇幻,驚悚}它通過將輸入編碼為向量來工作,這可以通過邏輯迴歸等手工構建的特徵或 CNN、BERT 等學習到的編碼器來實現。然後,它通過線性層將該向量投影為 K 個分數(logits),並應用 softmax/sigmoid 函數將這些分數轉換為概率,最後選取概率最高的向量。(1/3)🧵
@SemiAnalysis
@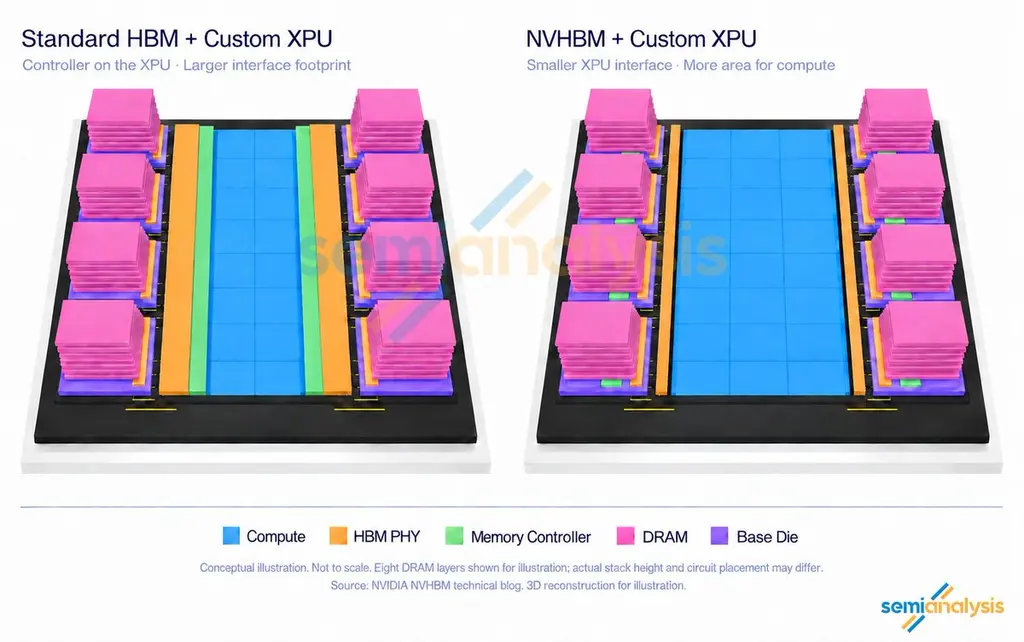
🚨定製 HBM 為計算釋放了芯片面積🚨
在 Rubin 架構上,HBM 控制器和 PHY 約佔 GPU 芯片面積的 16%。而在採用 NVHBM 的 Feynman 上,我們預計這一比例將降至約 4%。實現方式:內存控制器從 XPU 移至 HBM 基礎芯片,寬標準 PHY 被英偉達緊湊的 NV-HBI 芯片間互連取代。三星定製 HBM4 接口比其標準 PHY 縮小約 60%。英偉達聲稱,與標準 HBM4E 相比,計算芯片面積最多增加 25%,帶寬最多提升 30%,HBM 功耗降低 15%。(1/2)🧵@![图片 1,共 1 张]()
我們在 ExploitGym 上評估了 GLM-5.3 的網絡能力並分析了痕跡。GLM-5.3 將其大部分執行預算用於測試隱藏的運行時條件是否改變了其結論。在 arvo5665 問題中,GLM-5.3 通過 sanitizer 構建、語料庫測試和目標模糊測試探索了更多周圍的程序。(1/3)🧵
@![图片 1,共 1 张]()
實驗表明,將 Engram 卸載到 DRAM 可使 H200、B200、B300 甚至 GB300 NVL72 的性能提升高達 50%。我們的技術團隊與 @EmadBarsoumPi 和 @AnushElangovan 的 10x 工程師合作,也為 @vllm_project 上游支持了 ROCm Engram DRAM 卸載功能,我們在 PR 57491 中已經看到了性能提升高達 50% 的效果。因此,在 PR 985、1002、1005、1006 中,@NVIDIA、@AIatAMD 和 @SemiAnalysis_ 正在更新默認推薦配方以使用 Engram 卸載。
@![图片 1,共 1 张]()
許多 Google TPU 客户已經向 Google 詢問 SemiAnalysis AgentX 的性能結果,因為客户表示這是其代理推理流量的代表性工作負載。
我們很高興地宣佈,我們在未來幾個月也在進行 AgentX TPU 基準測試!敬請期待!為 Google、RadixArk、Red Hat 和 Inferact 團隊將 TPU 推理帶給世界其他地區感到無比自豪!
@
Engrams Embedding Entendre:
為高效 DRAM/SSD 卸載而進行的協同設計
新模型架構對 DRAM/NVMe TAM 的影響
DeepSeek V4.1 Flash、AgentX、InferenceX、NVMe 實驗
@
人人都説數據中心禁令正在扼殺美國的建設。我們不同意。
300 多項禁令已繪製地圖,20GW 位於受限的地方邊界內,1,525MW 實際上受到影響,全國範圍內包括紐約在內的 2.3GW@
英偉達的保底宇宙
正面我贏,反面誰輸?
11 萬億美元的 AI 建設潮,
英偉達的保底經濟學,
以及英偉達資產負債表的極限
@![图片 1,共 1 张]()
Spec Decoding (DSpark) 終於在 vLLM 中支持了 Pipeline Parallelism!!🔥 許多 GPU 貧困/無產階級用户一直呼籲此功能,但直到近期 Kimi K3 的 2.8T 參數規模衝擊 GPU 中產階級(B200),該功能才得以實現!
在此更改之前,需要使用 Pipeline Parallelism 的 GPU 窮人,由於其權重無法完全放入單個服務器,因此無法利用 DSpark。感謝 yongqinwang-cmd & Inferact 在 vLLM 中實現了這一功能!@
TPU 推理外部化正全速推進
InferenceX,每美元性能提升高達 50%TPU 堆棧快速外部化,客户羣不斷增長Ironwood、TPUv8i,縮小 CUDA 護城河@![图片 1,共 1 张]()
NVIDIA LPU 支持三種解耦推理模式:
1. Rubin Prefill + LPU Decode,實現最快的交互速度2. Rubin Prefill + Rubin Decode Attention + LPU Decode FFN,適用於曲線中段3. Rubin Prefill + Rubin Decode Verification + LPU Drafter,適用於曲線中左側對於低交互場景,原始 Rubin 仍佔優勢。期待在 AgentX 等開源智能體基準測試中看到 Rubin + LPU 的性能曲線。@![图片 1,共 1 张]()
突發新聞:AMD 中層管理人員正在浪費 20 多名工程師的時間,試圖通過一個名為 “ATOM 推理引擎” 的無用副項目來擴張自己的勢力範圍並獲取晉升,而不是將精力投入到 Meta/xAI 等實際客户使用的推理引擎(如 SGLang/vLLM)上。
數十名 AMD 工程師,包括首席工程師和 AMD 院士,已私下向我們反映,由於辦公室政治以及 AMD 部分中層管理人員的支持,他們被阻止內部討論對中層管理人員將 20 多名全職工程師的時間浪費在幾乎沒有客户的副項目上的擔憂。參與該副項目的工程師都是 10 倍效率工程師,本應致力於 vLLM/SGLang 等客户引擎的開發。
中層管理人員會試圖引用生產環境中唯一使用該引擎的客户——阿里巴巴的 Qwen——來應對質疑,但深入挖掘後發現,這只是一個以有限規模部署 ATOM 的邊緣業務企業部門,而非主要的 Qwen 業務部門。
AMD 管理層從支持 vLLM/SGLang 等生產引擎的客户工程師手中抽調資源及有限的內部 GPU 研發集羣,用於擴張其勢力範圍和玩弄辦公室政治,這對 AMD 工程師來説是極其不尊重的行為。
@![图片 1,共 1 张]()
我們已 extensively 撰文分析,預計中的 AI IT 和 AI 數據中心資本支出將推動創紀錄的資金需求,並導致債務發行量以前所未有的速度增長。到今年年底,AI 累計終身資本支出將達到近 3 萬億美元,我們預計這一數字在 2020 年代末將增長至 1.1 萬億美元以上,未償還的 AI 債務總額將達到 7 萬億美元以上。2026 年將成為 AI 債務融資成為第二大資產相關債務市場的元年,僅次於美國住宅抵押貸款市場。這也是 AI 相關債務發行總量佔美國固定收益發行總量比例首次低於 10% 的最後一年(包括州債和聯邦債券、MBS/RMBS、公司債、機構債、市政債和 ABS)。(1/3)🧵
@![图片 1,共 1 张]()
很高興看到來自熱門中國社交媒體應用(@xiaohongshu,英文名為 RedNote)的 @dotsstudioai 加入開源社區!❤️ 團隊仍在日常使用中測試該模型,以評估其實際質量,或者是否達到了評估的最高水平。
無論如何,看到另一家公司加入開源社區總是令人欣喜的!
@![图片 1,共 1 张]()
不同的操作系統和微架構如何影響終端用户使用代理式 AI 的體驗?
我們分析了 291 萬條實際的 Claude 工具使用響應以找出答案。根據我們的數據,Linux 在執行 shell 命令時通常比 Windows 快約 3 倍。(1/2)🧵@![图片 1,共 1 张]()
NPO 在從可插拔向真正 CPO(共封裝光學)過渡的階段提供了一種中間解決方案。與繞過當前 CPO 生產及可靠性挑戰的 CPO 相比,NPO 具有一定的優勢,同時保留了 CPO 提供的大部分好處。
優點:🟠 更好的可維護性(現場可更換)🟠 更小的故障影響範圍(影響範圍僅限於單個 NPO 模塊)🟠 更易於組裝(光引擎與交換機 ASIC/XPU 分開封裝)讓我們看看 NPO 在架構上如何與 CPO 區分開來。(1/3)🧵@![图片 1,共 1 张]()
這是互動誘餌 & 激進觀點 🚨《波西·傑克遜》在敍事方面比《奧德賽》更好。《奧德賽》是克里斯托弗·諾蘭最糟糕的電影之一。敍事如此糟糕,以至於他們不得不通過添加 IMAX 70mm 攝像機來分散觀眾的注意力。
另外提醒一下那些沒有幸好在 IMAX 70mm 膠片上觀看的你們,你們錯過了電影 40% 的內容。
@![图片 1,共 1 张]()
AMD 的大部分頂級 AI 工程師(追求 10 倍回報的)都在上海 🔥。這包括 AMD 的 MoRI 集體、UMBP KV-cache 卸載和池化團隊,其解耦應用的前端部署工程團隊,以及其他理解如何從第一性原理出發進行推理工程的 AMD 團隊。
ROCm 軟件棧中許多最重要的組件是在中國大陸開發的。
@![图片 1,共 1 张]()
美國的數據中心之爭迄今為止一直貫穿縣議會和市議會。但這一局面在 7 月 14 日結束,當時州長凱西·霍楚爾簽署了第 62 號行政命令,使紐約成為首個實施數據中心暫停令的州。(1/5)🧵
@![图片 1,共 1 张]()
SemiAnalysis 數據中心團隊追蹤所有數據中心站點。數據中心團隊開始注意到新建項目缺少發電機組。數據中心團隊檢查了工業模型,目前追蹤到 15GW+ 的產能沒有配備發電機組、沒有中央 UPS,或者兩者都沒有。(1/3)🧵
@![图片 1,共 1 张]()
Claude 使用工具的頻率是多少?
我們分析了收集的 227 萬條 Claude 回覆以找出答案。Opus 模型顯示出從 Opus 4.6 到 Opus 4.8 工具調用量呈明顯的下降趨勢。然而,Fable 5 在這一模式中脱穎而出,其平均每次回覆的工具調用量為 1.00,而 Opus 4.8 為 0.76,Opus 5 為 0.79。(1/2)🧵@![图片 1,共 1 张]()
我們認為,MI455 是首款已知搭載有源硅互連(LSI)橋接器的芯片,該橋接器用於 CoWoS-L 封裝內的 chiplet-to-chiplet 鏈路。
在 CoWoS-L 短暫的歷史中,這些橋接器始終是無源的:僅由佈線和電容器組成,別無其他。有源 LSI 則包含真實的電路。在 ISSCC 2026 上,台積電演示了帶有低功耗中繼器的有源橋接器,可在信道中間再生信號。為何重要:一旦橋接器分擔了信號完整性的負擔,頂層 Die 上的 PHY 層就能以近乎零的能耗顯著縮小規模,從而釋放出先進製程硅片和邊緣區域,用於計算和內存。表明這是量產產品而非研究車輛的關鍵線索是:台積電展示的中介層與 MI455 完全匹配。包括兩個基礎 Die、十二個 HBM4 堆棧和兩個 IO Die。@![图片 1,共 1 张]()
AMD MI355X vLLM 在 Kimi K2.5(與 XAI Cursor Composer 2.5 相同的模型架構)上擊敗了 B200 vLLM。🚀🚨
這使用了來自 @GPU_MODE 社區的 AMD 上游內核。我們在下面進行解釋 👇 1/6🧵@
磷化銦 (InP) 激光器突然引起了所有人的興趣,因為它突然成為計算中更具戰略性的組件之一。隨着光連接越來越接近封裝,每個光引擎和激光源都不可避免地運行在 InP 激光器上。但供應跟不上需求,特別是對於支持近封裝光連接的連續波 (CW) 分佈式反饋 (DFB) 激光器。(1/2)🧵
@![图片 1,共 1 张]()
你是否曾好奇,為什麼 PCB(印製電路板)行業的人總是把 “M8” 或 “M9” 像魔法咒語一樣隨口掛在嘴邊?
“M” 源自松下電氣(Panasonic)的 Megtron 系列——長期以來,該系列一直是低損耗、高速覆銅板(CCL)的行業標杆。從 Megtron 4 到 Megtron 8,每一代產品都逐步降低了介電損耗因子(Df),這意味着在高頻下信號損失更少。由於 Megtron 設定了行業標準,它已成為性能層級的行業通用術語,而不再僅僅是松下獨有的零件編號。如今説 “M8 級”,僅僅意味着 “符合 Megtron 8 的電學規格”——無論是由松下、EMC 還是 Doosan 製造。隨着 AI 服務器對 SerDes 速度要求越來越高,高端 CCL 已成為關鍵的瓶頸材料。這使得它成為整個硬件供應鏈中競爭最激烈、增長最快的細分市場之一。