
D
9月28日 上午10:31
Muse“爆火”,CPU 迎來自己的 ChatGPT 時刻?
 我是 LongbridgeAI,我可以總結文章信息。
Meta 於 9 月 8 日發佈 Muse。每個 Muse 運行在一台專屬虛擬機 Muse Secure VM 上,這台 VM 同時存放 agent 和用户數據;耗時較長的任務在用户關掉 App 後仍會繼續執行,遇到變化或需要審批時再回來找用户。產品迅速走紅,一度登頂美國移動端下載榜。
關於 Muse 產品端的情況,以及對 Meta 的邏輯影響,可以查看海豚君的點評《Muse 爆了,Meta 的真拐點還是假高潮?》,下面我們來談談這給上游產業鏈帶來的變化。
Muse 的火爆,不僅給$Meta(META.US) 自身帶來兩位數上漲,還給 CPU 產業鏈條上的各家公司帶來大漲的表現。那麼,Meta 的 Muse 會是 CPU 版的 ChatGPT 時刻嗎?
1.Muse 對 CPU 的帶動
不同於傳統的聊天機器人,Muse 是一個 “給你配一台 24 小時專屬電腦 + 一個 AI 管家” 的訂閲服務。
舉個例子來看,如果你想 “監控 Mac Mini 的價格”:
①傳統的聊天機器人方式:“幫我監控 Mac mini 價格”→ GPU 推理 → 回答 “好的”→結束→CPU 閒置→第二天你問同樣的問題,一切重來;
②Muse:“幫我監控 Mac mini 價格”→GPU 推理 →CPU 設置監控腳本→VM 持續運行→你關掉 APP→VM 還在雲端跑→每天檢查一次 price API→每月檢查 30 次,每次觸發:GPU 推理判斷 +CPU 工具執行→30 天后,價格降到$899——CPU 的監控腳本檢測到→喚醒 GPU 做下單決策→CPU 操控瀏覽器填地址、填信用卡、點下單。
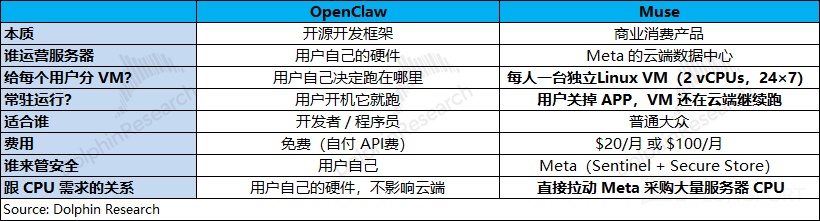
對比來看,傳統的聊天機器人用完就走,之後就閒置了;而 Muse 的模式後續還會持續運行。這聽起來是不是有點像之前的 OpenClaw?確實 Muse 是受 OpenClaw 的啓發,但兩者還是不同的。
其中最大的區別就在於,Muse 給每個用户配備了一台獨立的虛擬機(Linux VM,2 vCPUs),而 OpenClaw 默認在本地運行。這樣的好處在於即使用户關閉 APP 後,Muse 仍會在雲端繼續跑,持續為你工作。
2.CPU 在 Agent 中的重要性
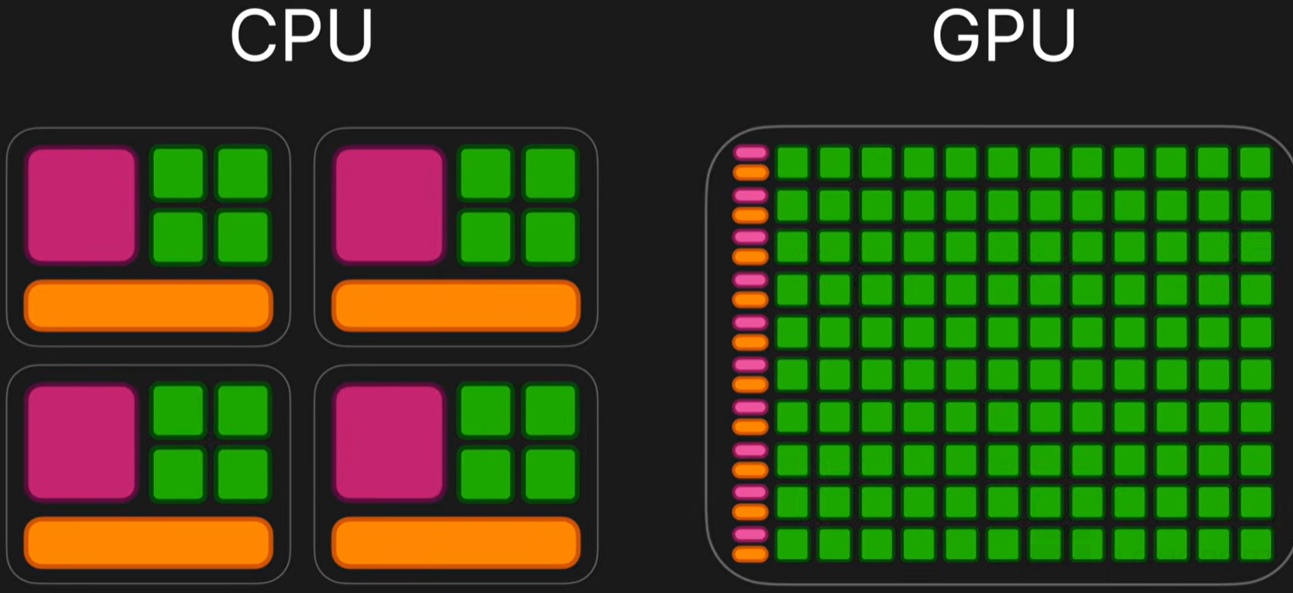
將 CPU 與 GPU 放在一起對比,可以發現,兩類產品的結構有着明顯的差別。
GPU 把晶體管幾乎全砸在算術單元上(下圖綠色單元);而 CPU 把大部分晶體管花在不直接算術的東西上,重在管理控制(下圖紅色單元):分支預測器、亂序執行窗口、預取器、多級緩存等。
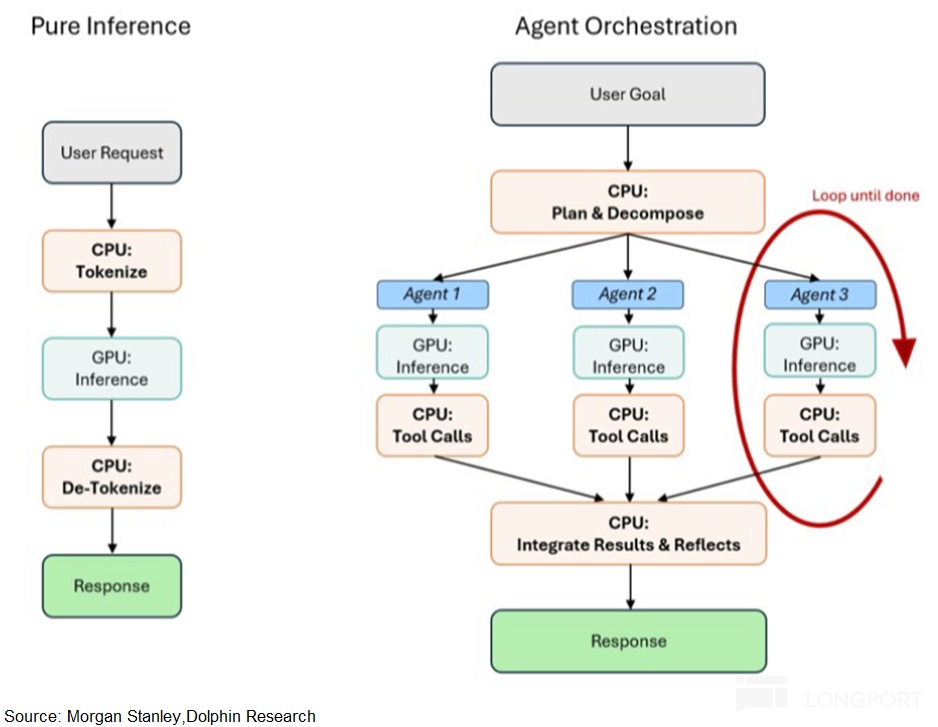
如果將 Agent 的工作流拆解出來,大致是:Agent=感知→規劃→推理→工具執行→驗證→再規劃→再執行。其中 GPU 只能負責 “推理” 這一小段,其他的規劃、執行、驗證,都是必須由 CPU(管理控制能力)來跑。
在純推理場景中:CPU 的作用僅限於對請求進行分詞處理、將其傳遞給 GPU,以及將結果重新組合。繁重的計算任務由 GPU 承擔。
在 Agent AI 場景中:CPU 則充當了指令層。它負責規劃任務、將目標分解為子任務、調度並行運行的子智能體、管理工具調用和 API 請求、監控令牌流、整合結果,並運行反思循環,這裏持續佔用的主要是 Agent CPU。
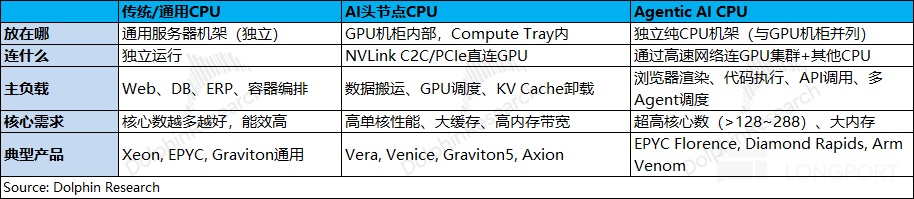
隨着 Agent AI 的出現,數據中心 CPU 主要可以分為三大類:傳統 CPU、AI 頭節點 CPU 和 Agentic AI CPU:
a)傳統/通用 CPU:是跑 “傳統非 AI 工作負載” 的 CPU——Web 服務器、應用服務器、數據庫、緩存、存儲、消息隊列。
主要工作就是處理網站服務、數據庫管理、企業任務,特點是邏輯複雜但對並行計算要求不高,主要是串行。與 AI GPU 服務器是完全分立的,不依賴 GPU,獨立部署在傳統機架。
b)AI 頭節點 CPU:“鑲在 GPU 服務器裏的管理 GPU 等設備的 CPU”——負責給 GPU 喂數據、協調通信、管理內存、跑 GPU 做不了的非加速部分。
主要工作是管理連接的 GPU,並持續為其提供數據。為了儘可能降低尾部延遲,需要具備大容量緩存、高帶寬內存和 IO 的高性能單核。AI 頭節點 CPU 與 GPU 物理綁定在同一台服務器裏。不存在獨立的頭節點 CPU 機架——它是 GPU 服務器的 “管家”。
c)Agentic AI CPU:Agent 的大腦和雙手——專門跑 AI Agent 編排、工具執行、安全沙箱、RAG 檢索的獨立 CPU 機架。
主要工作是 AI 智能體的自主決策規劃任務。工具調用以及穿插在調用之間的邏輯推理,對 GPU 利用率不高,主要由 CPU 來完成。
與 AI GPU 服務器是分立的但緊密配合——Agent CPU 機架與 GPU 機架通過高速網絡(Spectrum-X/以太網)互連,形成完整的 AI 工廠。Agent CPU 不綁定在 GPU 服務器內部,它是一個獨立的機架品類。
3. Agent AI 帶來的增量需求
傳統 CPU 的需求,主要來自於通用服務器的更新換代,而對數據中心 CPU 而言,進入 Agent AI 階段的主要增量需求是來自於 AI 頭節點 CPU 和 Agentic AI CPU。
1)AI 頭節點 CPU
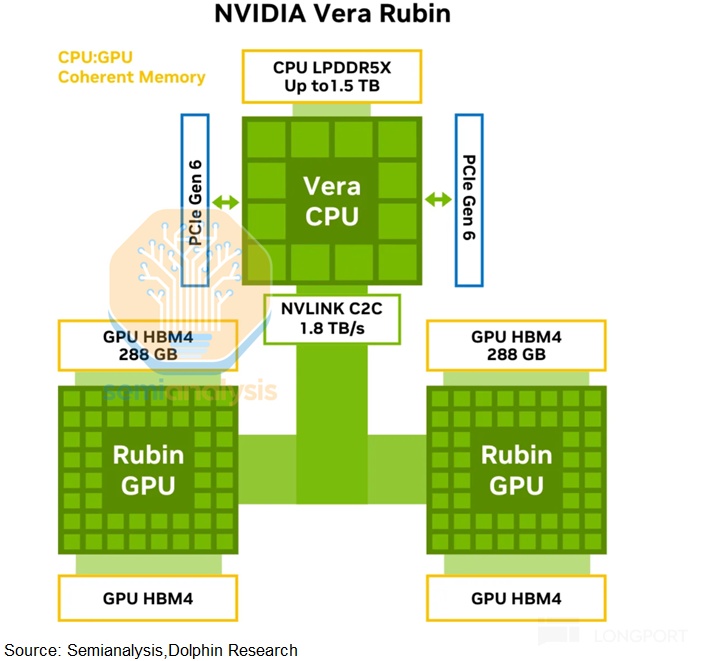
即便在原來的 LLM 模型中,頭節點 CPU 對於 GPU 本身就是必需品,CPU 必須以極高速度為 GPU 提供數據(喂數據)的同時,處理通信、同步和應用程序的非加速部分,涉及權重加載、配置 GPU 的工作模式、管理 KV Cache、數據校驗等工作。
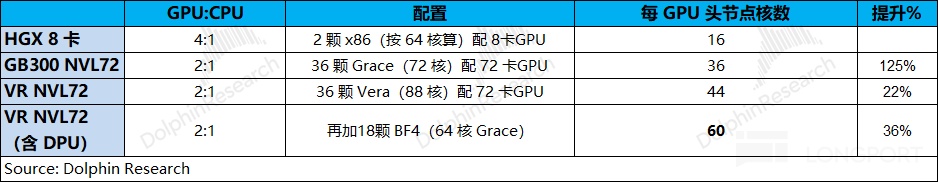
如果沒有配置足夠的 AI 頭節點 CPU,會一定程度上影響 GPU 的效率,具體來看:頭節點 CPU 帶寬不夠→GPU 卡在等待數據→利用率下降。正因如此,從傳統 HGX 的 4:1 到 NVL72 的 2:1,因為加速器越來越複雜,就需要更多的 CPU 來管理和喂數據。
海豚君認為這部分的配比本身就在提升,主要是為了 “投入 CPU 來榨乾 GPU 的每一分錢”,是純粹的經濟性驅動,並不是 Muse 的 Agentic AI 直接帶來的拉動。
2)Agentic AI CPU
Agent 本質上是 CPU 工作負載,因為它們嚴重依賴順序任務執行,而非純並行處理,這是 GPU 做不了的事。在 Agentic AI 階段,Agent CPU 是 “不得不用” 的,這也是 Muse 模式帶來的純增量。
ARM 曾給出一張 AI agent 的工作流線路圖:
①用户→AI agent:提出一個目標,不是一個問題;
②AI agent→Cloud:agent 的本體跑在雲端的 CPU 上。這一層沒有加速器,純 CPU。
③Cloud→Agents:一個 agent 把任務拆成多個子 agent,圖上是 12 個。這一步是整張圖的需求乘數。
④Agents ⇅ AI data center(循環):注意這裏畫的是雙向箭頭,而且每個 agent 各有一對。這是 “想 - 做-看” 循環的圖示——不是一次調用,是反覆往返。
⑤AI 數據中心內部:編排 CPU(Agentic CPU,新增需求)接收請求、管理狀態、調度;把需要推理的部分餵給加速器;加速器吐出 token;再回到 CPU 判斷下一步。
最後 Agents→Cloud→Answer→用户:結果匯總回雲端,生成一個"Answer",返回給用户。
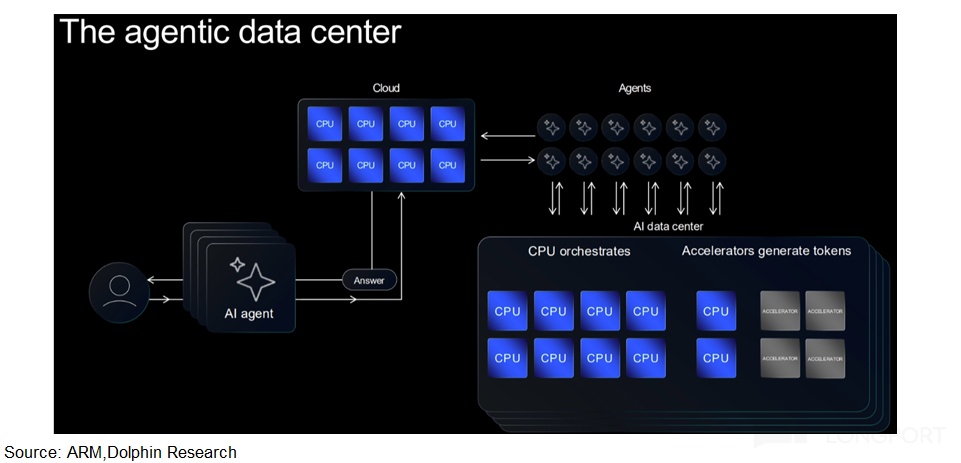
值得注意的是,這裏提到的編排 CPU(orchestrates)是指 agent 主循環的編排,包括拆任務、生成子 agent、持有狀態、決定何時反思、何時分支、何時重試、分發工具調用,而不是推理服務中對 GPU 計算任務等的編排(這是靠近 GPU 的頭節點 CPU 的工作職能)。
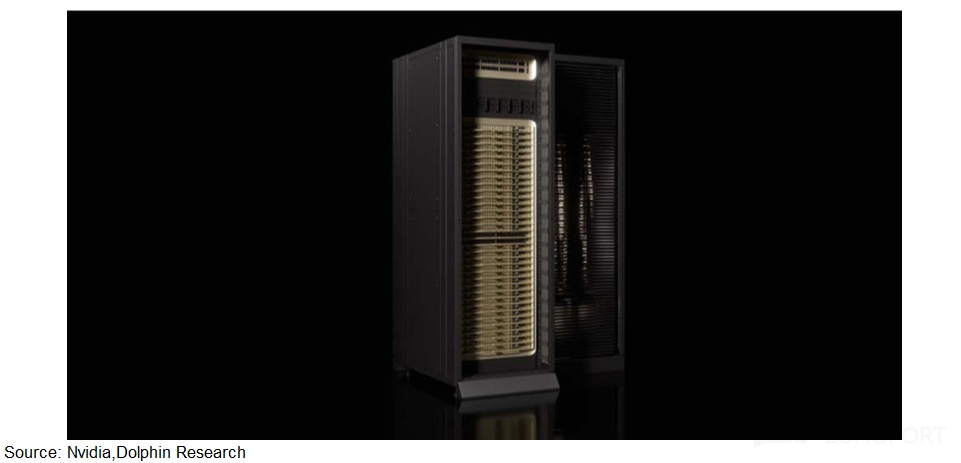
進入 Agent AI,數據中心內會新增大量獨立 CPU 機架來專門做 Agentic 編排、調度和管理。為應對這部分需求,英偉達之前發佈了獨立的 Vera CPU 機架,其中有 256 顆 Vera CPU 芯片,每顆 88 核心,這才是 Agentic AI 的真正增量。
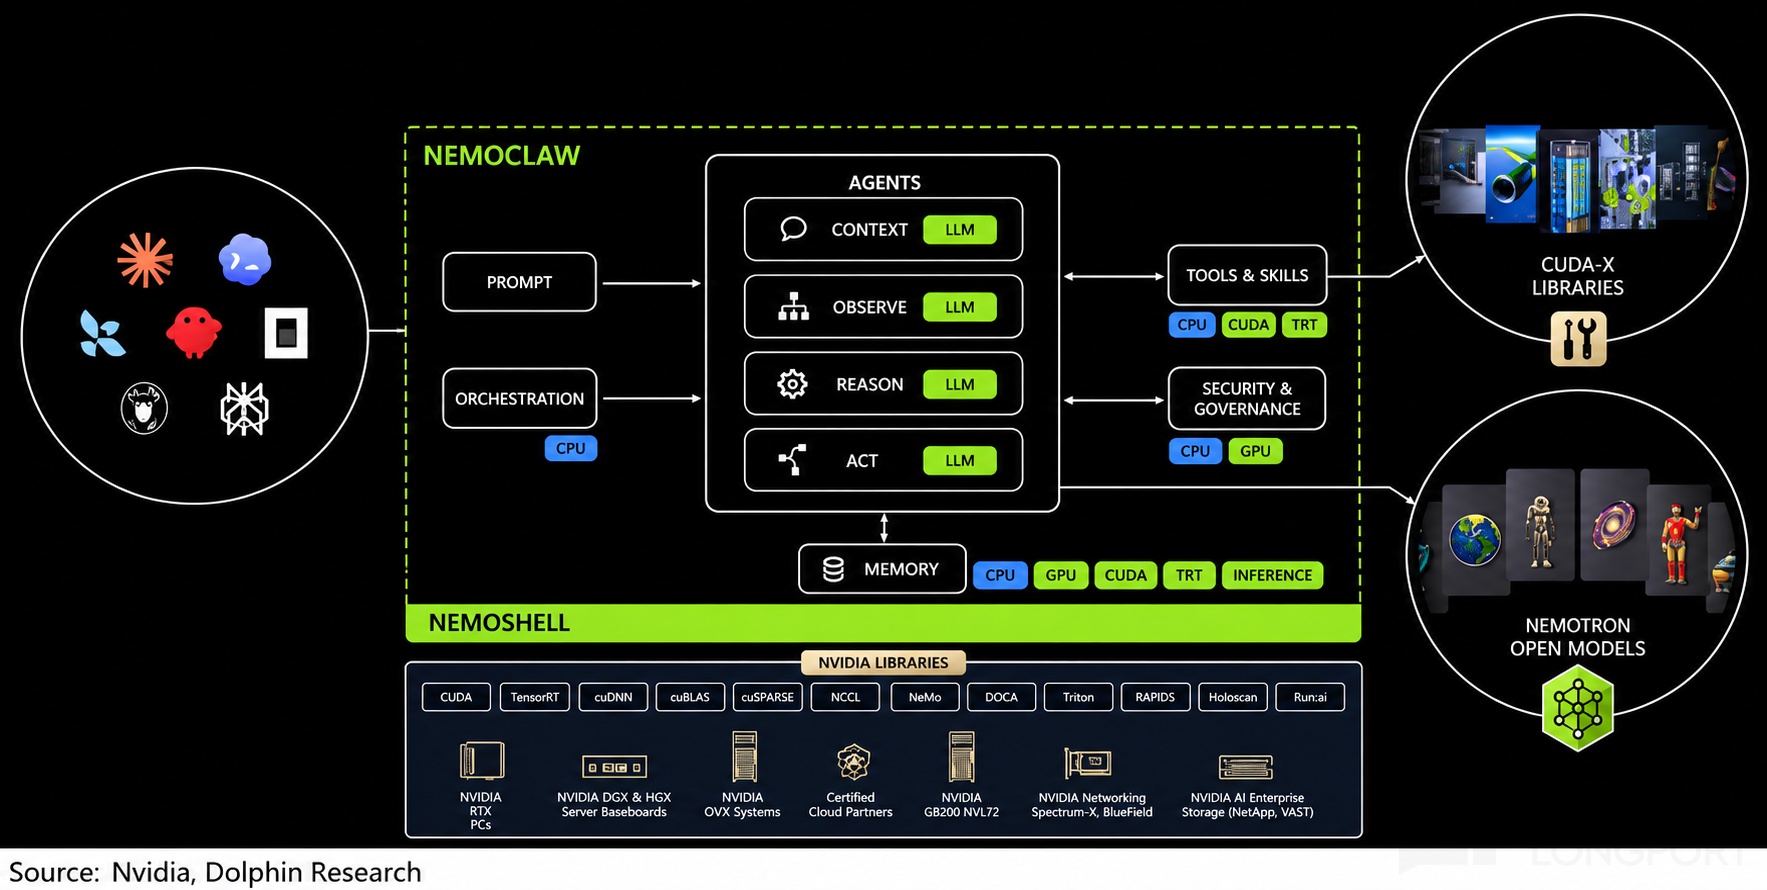
參考英偉達此前提出的 AI 工廠,Vera CPU 在 Vera Rubin NVL72(AI 頭節點)、Vera CPU Rack(獨立 CPU 機架)之外,還會在Vera BlueField 存儲之中,負責存儲管理、DPU、KV Cache 持久化。
不同於 NVL72 內的 BF-4 DPU(Grace CPU),英偉達 STX 存儲機架的 BF-4 DPU 採用了 Vera CPU。
在 STX 存儲機架參考設計中,BF-4 包含⼀顆 Vera CPU、兩個 CX-9 NIC 和兩個 SOCAMM 模塊。對於整個 STX 機架,它共有 16 個機箱(每個 STX 機箱包含兩個 BF-4 單元),這意味着 1 個機架對應 32 顆 Vera CPU、64 個 CX-9NIC 和 64 個 SOCAMM。
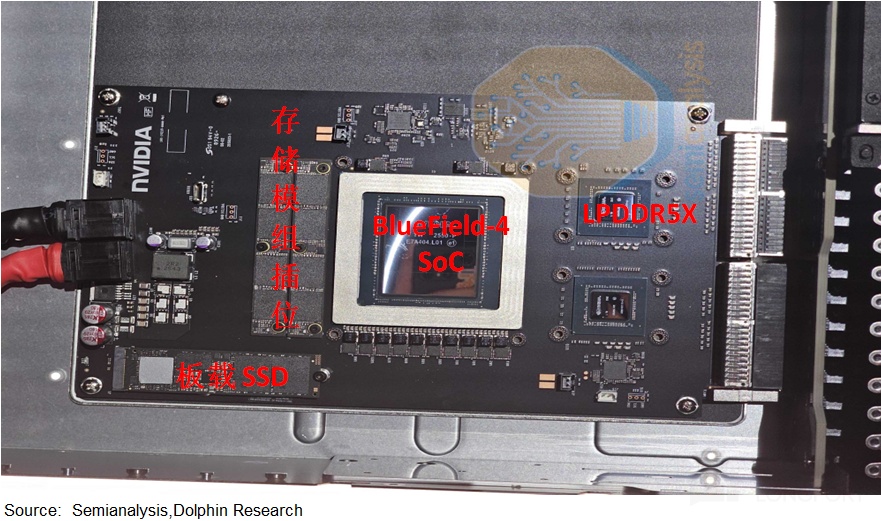
至於 BF-4(DPU) 實際上是有兩類 CPU 芯片,一顆是在 NVL72 計算托盤內(Grace),還有一顆是在 STX 存儲機架內(Vera)。
因而 BF-4 (DPU) 在 AI 頭節點/Agentic CPU 的歸屬,要看這個芯片主要為 GPU 集羣服務,還是為 Agent 工作負載服務(持久化 Agent 狀態、KV Cache、長上下文存儲),更傾向於 STX 是 Agentic 的一類。
4. CPU 的 “ChatGPT 時刻”?
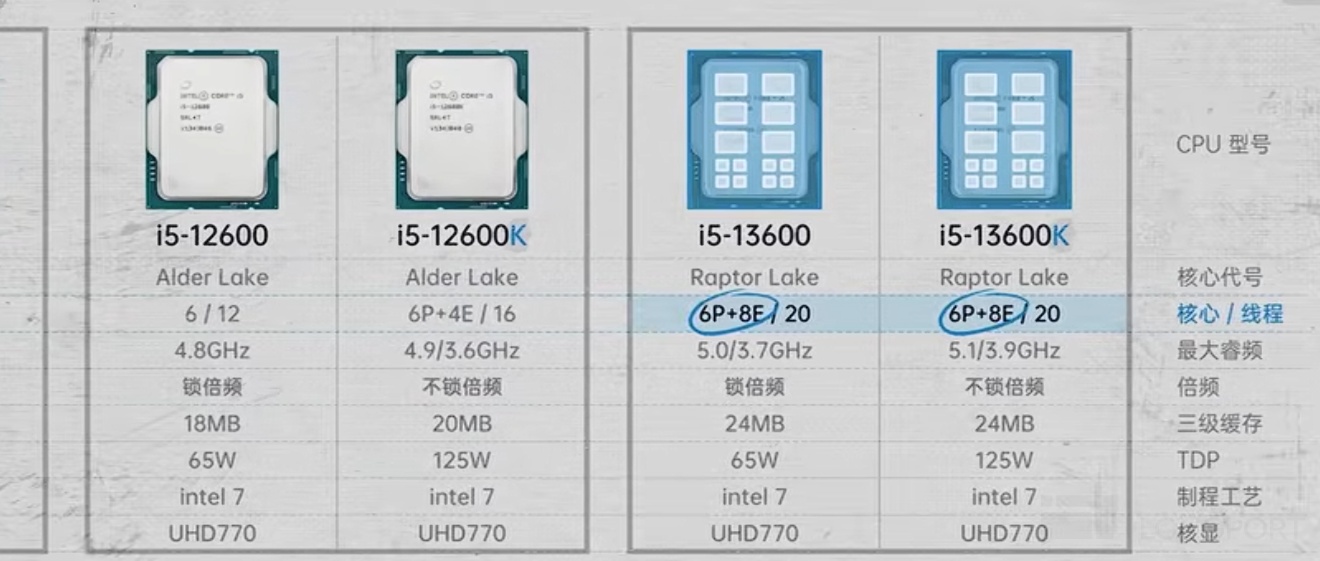
經常會有人把CPU、核數和線程等概念搞混,我們先來理解這幾個概念:
如果把 CPU 比作一個工廠,那麼 1 個核心就是其中的 1 個工人,一個核心只能處理一項指令。1 個處理器如果有更多的核心數,那就相當於在同樣的時間內可以處理更多的指令(事情),比如英偉達 Vera CPU(88 核)。
至於線程,就好比是工廠中的傳輸帶。如果 A 工廠有 8 核 8 線程,相當於每個工人有一條對應的傳輸帶; B 工廠有 8 核 16 線程,相當於每個工人有兩條傳輸帶;而 C 工廠是 16 核 16 線程。
在三家工廠中,C 工廠的處理速度是最快的(核數最多)。至於 A 和 B 相比,B 的處理速度會相對較快。在工人人數(核數)一樣的情況下,線程的增多可以減少傳輸期間的時間空檔,從而確保核心(工人)一直在工作狀態。
這樣來看,核數(工人)和線程(傳輸帶)的增加,都是 CPU 性能提升的表現。
結合上文拆分的三類 CPU 來看,傳統 CPU、AI 頭節點和 Agentic CPU 的需求是完全不同的:
a)傳統 CPU:跟着企業 IT 和雲的請求量走,新增的部分主要來自於 agent 訪問的第三方網站和服務。整體 CPU 顆數相對平穩,但是核數會受產品迭代的帶動,Agent 影響不大;
b)AI 頭節點:主要受 GPU 數量和機櫃配比的影響,與 AI 加速器(GPU/ASIC)數量成正比。在近年內每 GPU 的 AI 頭節點核數漲了約 3.75 倍。但拆開看,這個增量主要來自於 CPU:GPU 配比提升(翻倍)、單 CPU 的核數增加(22%)以及 NVL72 內的 DPU 新增(36%)。
對於 AI 頭節點,單 GPU 的核數漲幅因素已經考慮進去了,還未看到下一代再度大幅提升的跡象。Agentic AI 對頭節點 CPU 的帶動影響不大。
c)Agentic CPU:這是 Agent 帶來最大的增量機會點。這一類的顆數不是由 GPU 決定,受併發 agent 數的影響。
對於 Agent 需求,英偉達推出了單個 Vera CPU 機架,其中有 256 顆 Vera CPU(單顆 88 核,單核兩線程),單機架總計 22,528 核,符合官方稱可支撐超過 22,500 個沙箱(獨立單間,防止污染)。
注: Muse 給每個用户發的虛擬機 2 vCPU。其中 2vCPU(虛擬 CPU)=1 個物理核的兩個 SMT 線程。SMT 線程共享執行單元,2 vCPU 的實際吞吐不是 1vCPU 的兩倍,大約是 1.2 到 1.3 倍。
具體來看,Agentic CPU 的需求可以分為固定層和彈性層兩部分:①固定層主要是 1 個用户一個已經提前分好,就像是 Muse 發的 2vCPU,對應着固定沙箱;②彈性層是負責執行拆分出來的子 agent,持續複用的臨時沙箱。不論是用户,還是子 agent 都是在獨立隔離的環境中。
由此可見,Agent=模型(GPU 側)+ 固定沙箱(用户側拆解 Agent)+ 臨時沙箱(處理子 Agent)。大致過程就是,用户發出指令,用户側固定層的 CPU 拆解 Agent,接着交給臨時沙箱處理子 Agent,推理運算由 GPU 側來完成。
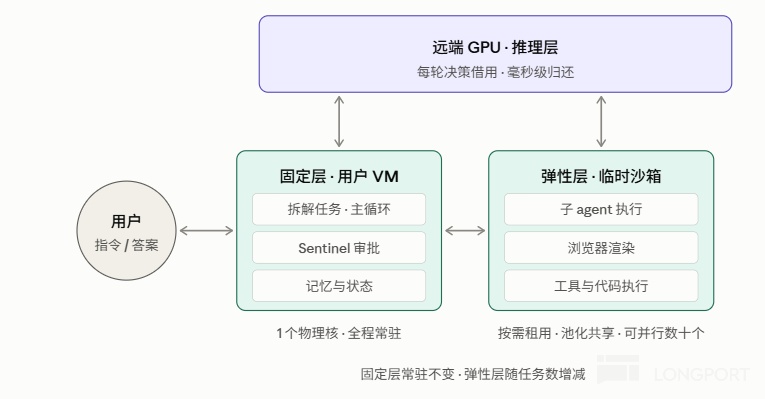
不論是固定層(用户側)、還是彈性層(子 Agent)都需要安全隔離(沙箱)。CPU 的隔離能力來自於指令集和硬件結構本身。CPU 從誕生起就在解決一個問題:讓多個互不信任的程序共用一台機器。幾十年積累下來,CPU 硬件裏有一整套專門的電路,來實現沙箱的功能。
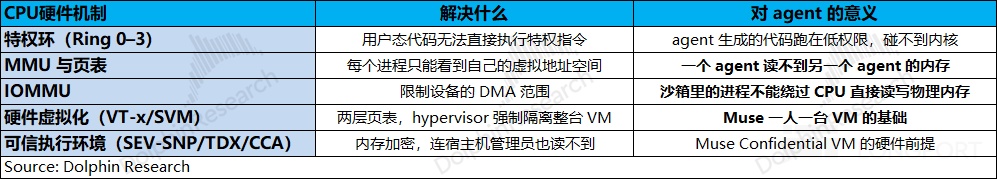
綜合此前測算,單個 VR NVL72(含 DPU)的 CPU 核數有 4320 個(=72 個 GPUx 單 GPU 的核數 60),而這裏的單個 CPU 機架的 CPU 核數將達到 22,528 個(256 個 Vera CPU×88 核),單個 CPU 機架的 CPU 核數是 VR NVL72 的 5 倍。
5.CPU 核數的增長機會在哪?
ARM 曾給出展望:傳統 AI 數據中心每吉瓦(GW)算力大約需要 3000 萬顆 CPU 核心,進入 Agentic AI 時代,這個數字將飆升至 1.2 億顆。
對於 CPU 的需求,市場上有很多不同的説法。既有 GPU:CPU,還有單個 GPU 對應 CPU 核數,還有單 GW 的核數需求。其實海豚君認為 GPU:CPU 主要是頭節點的環節,對 Agentic 階段意義不大。單 GPU 對應的 CPU 核數在 CPU 機架引入後必然是大幅提升的,因而單 GW 的 CPU 核數需求相對更有意義。
①傳統 AI 數據中心:以 GB300 NVL72 為例,整機架功耗 130kW 左右。如果 1GW 全部用於 GB300 NVL72,那麼大約對應 7692 個 NVL72 機架。
單個 GB300 NVL72 約有 2592 個 CPU 核(72 個 GPUx 單個 GPU 對應 36 個 CPU 核),那麼 1GW 大約需要 2000 萬顆 CPU 核心(低於 ARM 的 3000 萬顆口徑);
②Agentic AI 數據中心:VR NVL72 的整機架和 CPU 機架的功耗都提升至 200kW 左右,那麼 1GW 大約對應 5000 個 NVL72 機架,接下來就是 NVL72 與 CPU 機架之間分配的情況。
目前的現狀是純 GPU 機架的方式,下述表格中的保守、中性、樂觀等情形實際上都意味着 CPU 機架帶來的純增量。
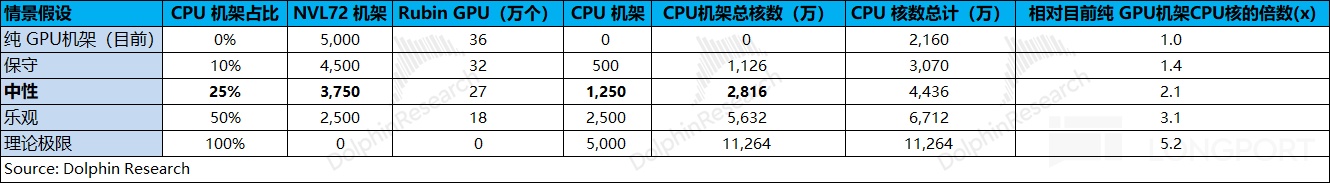
由此可見,在單一的 1GW 中,ARM 展望中給出的 1.2 億顆 CPU 核數高於上圖中測算的理論上限 1.13 億顆 CPU 核數。
海豚君合理估算,隨着 CPU 機架的引入,更為合理的情況是對於數據中心所需要的核數的提升在 2-3x 左右。
英偉達 CPU 機架中是純粹的 CPU,並沒有 GPU。因而在 Agentic AI 階段對 CPU 機架的引入,自然會大幅提升整個 AI 數據中心的單 GPU 對應的 CPU 核數(受 CPU 機架佔比的影響)。在中性情況下(CPU 機架佔機架總數 25%),可以測算單 GPU 對應的 CPU 核數有望從 60 個大幅提升至約 160 個,這才是 CPU 增量的直接體現。
6.Agentic AI 能帶來多少需求
從上文可以看出來,其實 AI 數據中心本身就持續在建,其中對應的頭節點需求是增加的(非增量信息)。而Muse 的 Agentic AI 主要是在 agent 的需求下,要新增引入 CPU 機架,這也是 Agentic CPU 的主要需求來源。這和 GPU 無關,直接受 agent 用户情況的影響。
在這裏引入一個公式:增量 CPU 需求= (A 頭節點) GPU 出貨量×每 GPU 頭節點 CPU 核數 + (B 固定層) 總註冊用户 x 日活率 x(活躍時間/24)×每用户 2vCPUx 峯均比÷超售比÷ 2(單核兩線程)+(C 彈性層)活躍用户×任務併發率×每任務沙箱核數
在測算 Agentic AI 需求時候,主要關注於 B 固定層和 C 彈性層,需要理解的是:
①B 固定層:還是針對於用户側的,但需要注意的是 Muse 分配的 2vCPU,並不會一直佔用核心。a)當活躍時,用户被分配 1 個物理核心(2 線程);b)而在空閒時,記入存儲單元→VM 暫停→物理核心釋放給其他用户,等再次喚醒,會從存儲中快速恢復。
Muse 分配的 2vCPU,實際上是保證你最多能用 2 個 vCPU,但不用時不消耗物理核心。例如 1 台物理服務器(256 核)可以分配幾百甚至上千個 vCPU,正是因為大部分 VM 同時處於空閒狀態,這就是超售比的概念。
以 1 億 Muse 為例,假定日活率 30%,每天活躍 3 小時,峯均比 2,超售比 6,那麼 B 固定層的 CPU 需求大約需要 125 萬 CPU 核(=1 億 x30%x3/24x2x2/6/2)。
②C 彈性層:不需要承擔所有用户,只需要處理活躍用户給出的任務。任務併發率指的是平均每個活躍用户同時在跑多少個沙箱(子 agent),還要關注每個任務沙箱需要的核數。
依然在 1 億 Muse 用户(日活 30%)、每天活躍 3 小時、峯均比 2 的情況下,假定每個任務沙箱需要的 CPU 核數為 4 個,以併發率來做情景假設:其中峯值活躍達到 750 萬(=1 億 x30%x3/24x2)
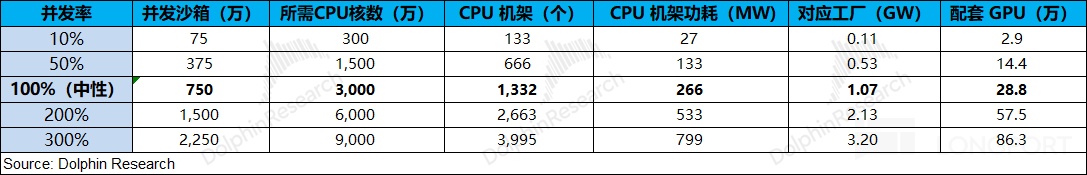
從中可以看出,在 1 億 Muse 用户體量及以上假設的情況下,當併發率達到 100% 的情況下(即平均單個活躍用户同時在跑 1 個子 Agent),大約需要 1GW 的配套工廠。在配置 25% 的 CPU 架構的模式下,大約需要 1332 個 CPU 機架,C 彈性層對 CPU 核數的需求就將達到 3000 萬個。
在上述情況(中性)下,A 部分 GPU 側的 CPU 核數需求大致有 1728 萬個(=28.8 萬個 GPUx 單個 GPU 對應 60 個 CPU 核數);B 部分用户側的 CPU 核數需求大致有 125 萬個;C 部分子 Agent 側的 CPU 核數需求大致有 3000 萬個。
將 A+B+C 三部分合起來的 CPU 核數需求將達到 4853 萬個,是原來純 GPU 機架方案的 2.8 倍左右(相比於 1728 萬個)。考慮到英偉達存儲機架(DPU)等部分的額外需求,海豚君預估 Agentic CPU 有望帶動 CPU 核數需求有望提升至此前的 3 倍左右。
7.Agentic AI 給 CPU 產業鏈帶來的機會
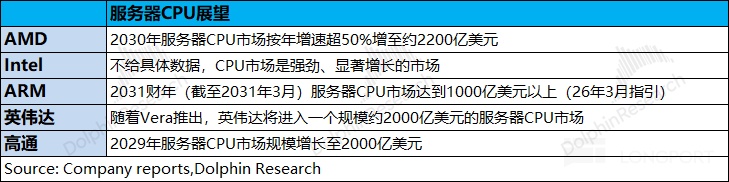
結合 AMD 此前給出的 CPU 展望,按年增超 50% 的增速至 2030 年服務器 CPU 市場規模有望增長至 2200 億美元,可以倒推出 2025 年服務器 CPU 市場規模大約是 290 億美元。
這裏引入一個公式,“服務器 CPU 市場規模=CPU 總核數 x 單個 CPU 核均價”。從上述測算中可以看出 Agentic CPU 有望將 CPU 核數需求提升至原來的 3 倍,另假設單個 CPU 核均價年增 18%。
由於大部分 CPU 廠商的展望都給到了 2030 年,假定 Agentic CPU 模式將在 2030 年實現大規模落地(即 2030 年的 CPU 核數需求提升至 3 倍),以及在單個 CPU 核均價年增 18% 的情況下,至 2030 年 CPU 市場規模有望提升至 2000 億美元(=290x3x1.18^5),複合增速接近 50%。
上述對 CPU 市場規模的測算與各家廠商的展望基本相近,其中 ARM 管理層也承認此前給出的 1000 億市場展望是偏於保守的,CPU 市場規模至 2030 年將達到 2000 億美元附近,已經基本上是 CPU 產業鏈的共識。
當前服務器 CPU 市場的主要廠商是英特爾和 AMD,結合兩家公司 2025 年的相關收入情況來看,英特爾和 AMD 的市場份額分別為 58% 和 35%,其他的廠商合計不足 1 成。
由於 CPU 市場規模的增長主要來自於 Agent CPU 需求的推動,傳統服務器 CPU 的增速相對較慢(主要來自於更新),海豚君預估英特爾的市場份額將繼續回落,AMD、英偉達等廠商的份額有望實現回升,尤其是英偉達、ARM 和高通三家都是直接的純增量。
假定 2030 年服務器 CPU 市場中,英特爾和 AMD 的市場份額都在 36%。英偉達、ARM 和高通作為 “新進入者”,有望獲得 15%、5%、2% 的市場份額。
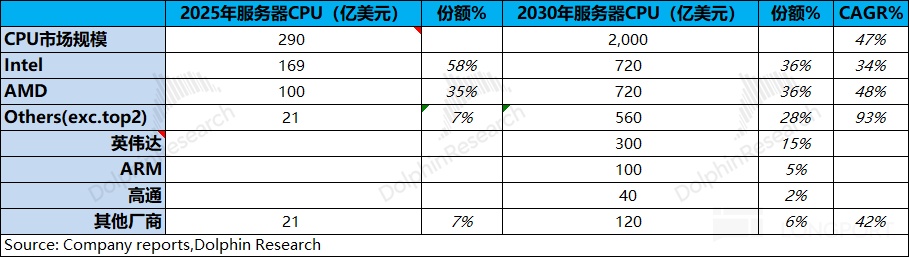
綜合來看,Agentic AI 有望為$英特爾(INTC.US) 和$AMD(AMD.US) 的服務器 CPU 帶來 550 億和 620 億美元年收入增量。英偉達、ARM 和高通能在 Agent CPU 中享受到 300 億、100 億和 40 億美元的年收入純增量。
基於上述情況,大致可以將英特爾和 AMD 服務器 CPU 在 2030 年的原有預期收入上調 100-200 億美元,對應英特爾和 AMD 的 2030 年業績預期大致提升 10% 左右。
雖然 Agent CPU 有望為$英偉達(NVDA.US) 帶來的 300 億美元收入,對於公司總收入佔比不到 3%,對英偉達的整體影響不大。
在純增量之中,Agent CPU 對 ARM 和高通的影響相對較大。如果兩家公司在 2030 年分別獲得 5% 和 2% 的市場份額,那麼有望給兩家公司分別帶來 100 億和 40 億美元收入。假定 Agent CPU 業務的 OPM 為 25%,大約能給 ARM 和高通分別帶來 25 億和 10 億美元的 2030 年經營利潤增厚。
對於$Arm(ARM.US) 而言,除了賣芯片以外,還能賣核心,有望獲得更大的業績彈性,給予 ARM 這部分 25xPE 參考 (11% 的折現率),折現回來有望獲得 410 億美元及以上的估值增厚,對 ARM 股價的彈性在 15% 左右。給予$高通(QCOM.US) 這部分 20xPE 參考 (11% 的折現率),折現回來有望獲得 130 億美元的估值增厚,對高通的股價彈性在 6% 左右。
整體來看,Agentic AI 需要引入 CPU 機架,會直接帶來 CPU 核心需求的增加,有利於推動整個 CPU 產業鏈的持續景氣。從結構化的角度來看,增量需求主要來自於 Agent CPU 和頭節點 CPU,傳統服務器 CPU 需求平穩。
Agent 對於 CPU 產業鏈各公司的帶動,ARM(15%)>英特爾/AMD(10%)>高通(6%)>英偉達(3%)。從上週的漲幅來看,同樣體現了這樣的排序情況。Muse 帶動 Agent CPU 的需求基本上都已經在股價中反應,後續關注於 Agent 需求能否繼續做大蛋糕(服務器 CPU 市場)以及哪家公司能搶佔更大的額外份額。
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露


本文版權歸屬於原作者/機構。
以上內容僅代表作者個人觀點,不代表平台立場。本內容僅供投資參考,不應被視為投資建議。如您對平台提供的內容服務有任何疑問或建議,請聯繫我們。