
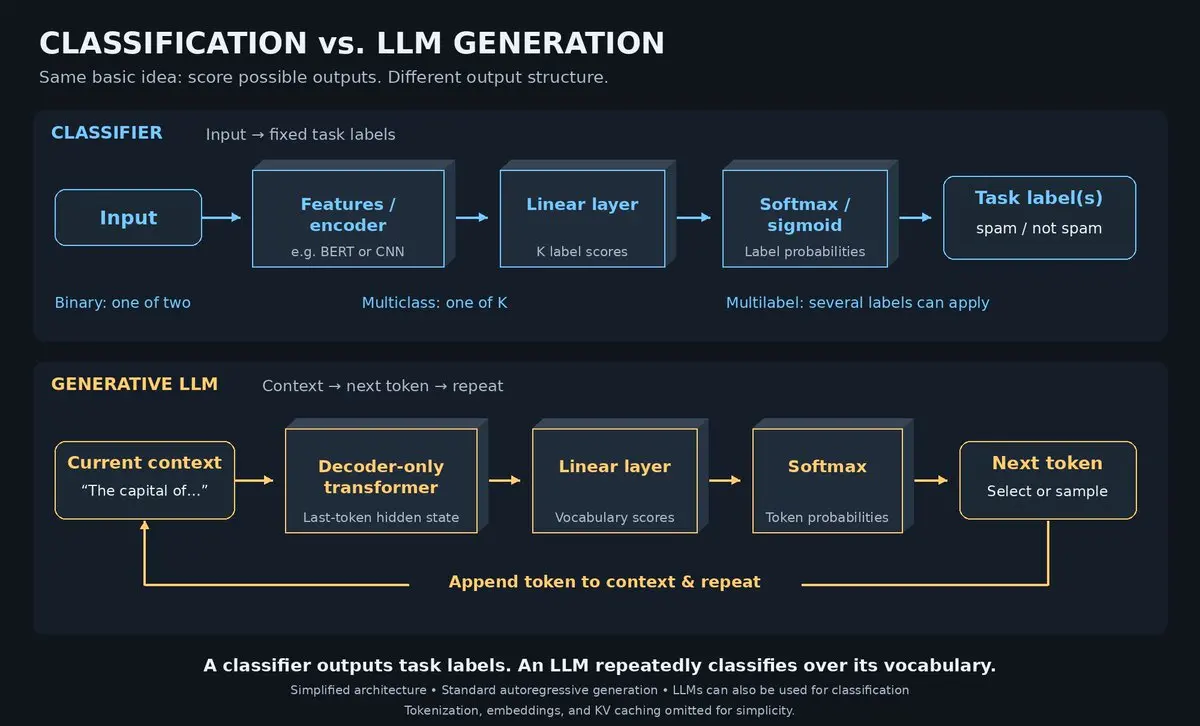
分类器将输入映射到一组固定的标签。分类器的主要类型包括:
🟠 二分类:邮件 ∈ {垃圾邮件,非垃圾邮件}🟠 多分类:文本 ∈ {正面,中性,负面}🟠 多标签分类:电影 ⊆ {动作,恐怖,喜剧,爱情,奇幻,惊悚}它通过将输入编码为向量来工作,这可以通过逻辑回归等手工构建的特征或 CNN、BERT 等学习到的编码器来实现。然后,它通过线性层将该向量投影为 K 个分数(logits),并应用 softmax/sigmoid 函数将这些分数转换为概率,最后选取概率最高的向量。(1/3)🧵
@SemiAnalysis
@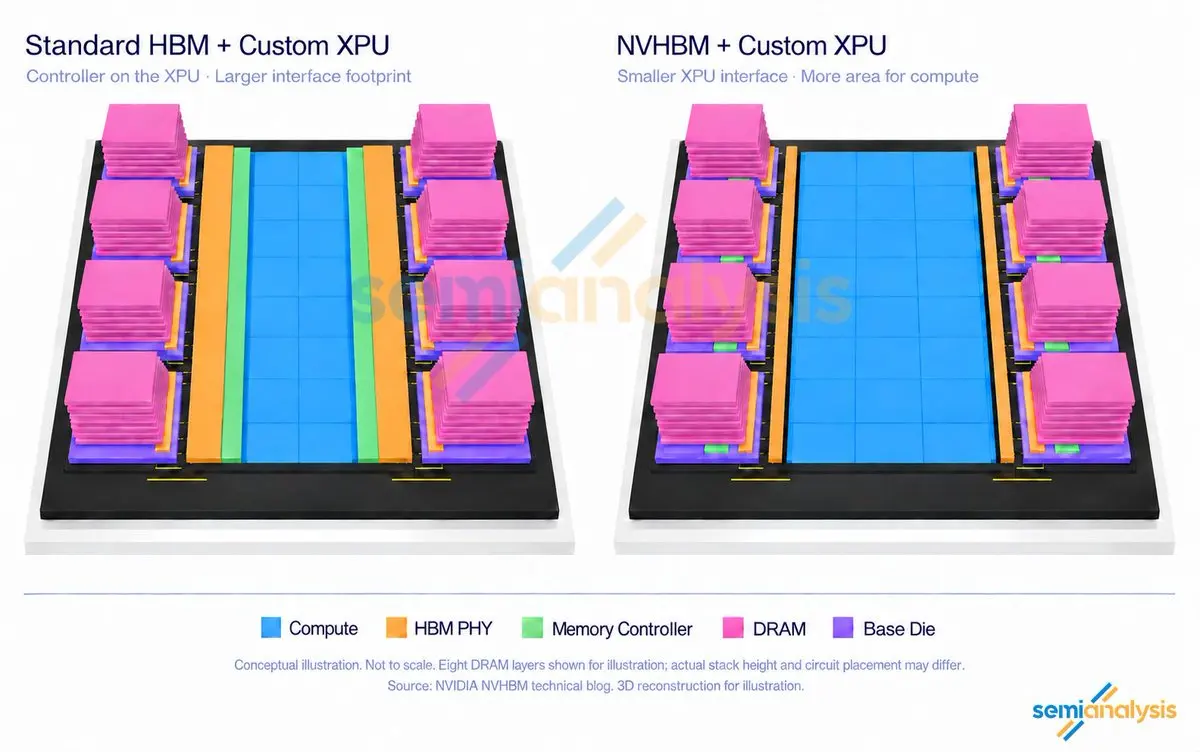
🚨定制 HBM 为计算释放了芯片面积🚨
在 Rubin 架构上,HBM 控制器和 PHY 约占 GPU 芯片面积的 16%。而在采用 NVHBM 的 Feynman 上,我们预计这一比例将降至约 4%。实现方式:内存控制器从 XPU 移至 HBM 基础芯片,宽标准 PHY 被英伟达紧凑的 NV-HBI 芯片间互连取代。三星定制 HBM4 接口比其标准 PHY 缩小约 60%。英伟达声称,与标准 HBM4E 相比,计算芯片面积最多增加 25%,带宽最多提升 30%,HBM 功耗降低 15%。(1/2)🧵@![图片 1,共 1 张]()
我们在 ExploitGym 上评估了 GLM-5.3 的网络能力并分析了痕迹。GLM-5.3 将其大部分执行预算用于测试隐藏的运行时条件是否改变了其结论。在 arvo5665 问题中,GLM-5.3 通过 sanitizer 构建、语料库测试和目标模糊测试探索了更多周围的程序。(1/3)🧵
@![图片 1,共 1 张]()
实验表明,将 Engram 卸载到 DRAM 可使 H200、B200、B300 甚至 GB300 NVL72 的性能提升高达 50%。我们的技术团队与 @EmadBarsoumPi 和 @AnushElangovan 的 10x 工程师合作,也为 @vllm_project 上游支持了 ROCm Engram DRAM 卸载功能,我们在 PR 57491 中已经看到了性能提升高达 50% 的效果。因此,在 PR 985、1002、1005、1006 中,@NVIDIA、@AIatAMD 和 @SemiAnalysis_ 正在更新默认推荐配方以使用 Engram 卸载。
@![图片 1,共 1 张]()
许多 Google TPU 客户已经向 Google 询问 SemiAnalysis AgentX 的性能结果,因为客户表示这是其代理推理流量的代表性工作负载。
我们很高兴地宣布,我们在未来几个月也在进行 AgentX TPU 基准测试!敬请期待!为 Google、RadixArk、Red Hat 和 Inferact 团队将 TPU 推理带给世界其他地区感到无比自豪!
@
Engrams Embedding Entendre:
为高效 DRAM/SSD 卸载而进行的协同设计
新模型架构对 DRAM/NVMe TAM 的影响
DeepSeek V4.1 Flash、AgentX、InferenceX、NVMe 实验
@
人人都说数据中心禁令正在扼杀美国的建设。我们不同意。
300 多项禁令已绘制地图,20GW 位于受限的地方边界内,1,525MW 实际上受到影响,全国范围内包括纽约在内的 2.3GW@
英伟达的保底宇宙
正面我赢,反面谁输?
11 万亿美元的 AI 建设潮,
英伟达的保底经济学,
以及英伟达资产负债表的极限
@![图片 1,共 1 张]()
Spec Decoding (DSpark) 终于在 vLLM 中支持了 Pipeline Parallelism!!🔥 许多 GPU 贫困/无产阶级用户一直呼吁此功能,但直到近期 Kimi K3 的 2.8T 参数规模冲击 GPU 中产阶级(B200),该功能才得以实现!
在此更改之前,需要使用 Pipeline Parallelism 的 GPU 穷人,由于其权重无法完全放入单个服务器,因此无法利用 DSpark。感谢 yongqinwang-cmd & Inferact 在 vLLM 中实现了这一功能!@
TPU 推理外部化正全速推进
InferenceX,每美元性能提升高达 50%TPU 堆栈快速外部化,客户群不断增长Ironwood、TPUv8i,缩小 CUDA 护城河@![图片 1,共 1 张]()
NVIDIA LPU 支持三种解耦推理模式:
1. Rubin Prefill + LPU Decode,实现最快的交互速度2. Rubin Prefill + Rubin Decode Attention + LPU Decode FFN,适用于曲线中段3. Rubin Prefill + Rubin Decode Verification + LPU Drafter,适用于曲线中左侧对于低交互场景,原始 Rubin 仍占优势。期待在 AgentX 等开源智能体基准测试中看到 Rubin + LPU 的性能曲线。@![图片 1,共 1 张]()
突发新闻:AMD 中层管理人员正在浪费 20 多名工程师的时间,试图通过一个名为 “ATOM 推理引擎” 的无用副项目来扩张自己的势力范围并获取晋升,而不是将精力投入到 Meta/xAI 等实际客户使用的推理引擎(如 SGLang/vLLM)上。
数十名 AMD 工程师,包括首席工程师和 AMD 院士,已私下向我们反映,由于办公室政治以及 AMD 部分中层管理人员的支持,他们被阻止内部讨论对中层管理人员将 20 多名全职工程师的时间浪费在几乎没有客户的副项目上的担忧。参与该副项目的工程师都是 10 倍效率工程师,本应致力于 vLLM/SGLang 等客户引擎的开发。
中层管理人员会试图引用生产环境中唯一使用该引擎的客户——阿里巴巴的 Qwen——来应对质疑,但深入挖掘后发现,这只是一个以有限规模部署 ATOM 的边缘业务企业部门,而非主要的 Qwen 业务部门。
AMD 管理层从支持 vLLM/SGLang 等生产引擎的客户工程师手中抽调资源及有限的内部 GPU 研发集群,用于扩张其势力范围和玩弄办公室政治,这对 AMD 工程师来说是极其不尊重的行为。
@![图片 1,共 1 张]()
我们已 extensively 撰文分析,预计中的 AI IT 和 AI 数据中心资本支出将推动创纪录的资金需求,并导致债务发行量以前所未有的速度增长。到今年年底,AI 累计终身资本支出将达到近 3 万亿美元,我们预计这一数字在 2020 年代末将增长至 1.1 万亿美元以上,未偿还的 AI 债务总额将达到 7 万亿美元以上。2026 年将成为 AI 债务融资成为第二大资产相关债务市场的元年,仅次于美国住宅抵押贷款市场。这也是 AI 相关债务发行总量占美国固定收益发行总量比例首次低于 10% 的最后一年(包括州债和联邦债券、MBS/RMBS、公司债、机构债、市政债和 ABS)。(1/3)🧵
@![图片 1,共 1 张]()
很高兴看到来自热门中国社交媒体应用(@xiaohongshu,英文名为 RedNote)的 @dotsstudioai 加入开源社区!❤️ 团队仍在日常使用中测试该模型,以评估其实际质量,或者是否达到了评估的最高水平。
无论如何,看到另一家公司加入开源社区总是令人欣喜的!
@![图片 1,共 1 张]()
不同的操作系统和微架构如何影响终端用户使用代理式 AI 的体验?
我们分析了 291 万条实际的 Claude 工具使用响应以找出答案。根据我们的数据,Linux 在执行 shell 命令时通常比 Windows 快约 3 倍。(1/2)🧵@![图片 1,共 1 张]()
NPO 在从可插拔向真正 CPO(共封装光学)过渡的阶段提供了一种中间解决方案。与绕过当前 CPO 生产及可靠性挑战的 CPO 相比,NPO 具有一定的优势,同时保留了 CPO 提供的大部分好处。
优点:🟠 更好的可维护性(现场可更换)🟠 更小的故障影响范围(影响范围仅限于单个 NPO 模块)🟠 更易于组装(光引擎与交换机 ASIC/XPU 分开封装)让我们看看 NPO 在架构上如何与 CPO 区分开来。(1/3)🧵@![图片 1,共 1 张]()
这是互动诱饵 & 激进观点 🚨《波西·杰克逊》在叙事方面比《奥德赛》更好。《奥德赛》是克里斯托弗·诺兰最糟糕的电影之一。叙事如此糟糕,以至于他们不得不通过添加 IMAX 70mm 摄像机来分散观众的注意力。
另外提醒一下那些没有幸好在 IMAX 70mm 胶片上观看的你们,你们错过了电影 40% 的内容。
@![图片 1,共 1 张]()
AMD 的大部分顶级 AI 工程师(追求 10 倍回报的)都在上海 🔥。这包括 AMD 的 MoRI 集体、UMBP KV-cache 卸载和池化团队,其解耦应用的前端部署工程团队,以及其他理解如何从第一性原理出发进行推理工程的 AMD 团队。
ROCm 软件栈中许多最重要的组件是在中国大陆开发的。
@![图片 1,共 1 张]()
美国的数据中心之争迄今为止一直贯穿县议会和市议会。但这一局面在 7 月 14 日结束,当时州长凯西·霍楚尔签署了第 62 号行政命令,使纽约成为首个实施数据中心暂停令的州。(1/5)🧵
@![图片 1,共 1 张]()
SemiAnalysis 数据中心团队追踪所有数据中心站点。数据中心团队开始注意到新建项目缺少发电机组。数据中心团队检查了工业模型,目前追踪到 15GW+ 的产能没有配备发电机组、没有中央 UPS,或者两者都没有。(1/3)🧵
@![图片 1,共 1 张]()
Claude 使用工具的频率是多少?
我们分析了收集的 227 万条 Claude 回复以找出答案。Opus 模型显示出从 Opus 4.6 到 Opus 4.8 工具调用量呈明显的下降趋势。然而,Fable 5 在这一模式中脱颖而出,其平均每次回复的工具调用量为 1.00,而 Opus 4.8 为 0.76,Opus 5 为 0.79。(1/2)🧵@![图片 1,共 1 张]()
我们认为,MI455 是首款已知搭载有源硅互连(LSI)桥接器的芯片,该桥接器用于 CoWoS-L 封装内的 chiplet-to-chiplet 链路。
在 CoWoS-L 短暂的历史中,这些桥接器始终是无源的:仅由布线和电容器组成,别无其他。有源 LSI 则包含真实的电路。在 ISSCC 2026 上,台积电演示了带有低功耗中继器的有源桥接器,可在信道中间再生信号。为何重要:一旦桥接器分担了信号完整性的负担,顶层 Die 上的 PHY 层就能以近乎零的能耗显著缩小规模,从而释放出先进制程硅片和边缘区域,用于计算和内存。表明这是量产产品而非研究车辆的关键线索是:台积电展示的中介层与 MI455 完全匹配。包括两个基础 Die、十二个 HBM4 堆栈和两个 IO Die。@![图片 1,共 1 张]()
AMD MI355X vLLM 在 Kimi K2.5(与 XAI Cursor Composer 2.5 相同的模型架构)上击败了 B200 vLLM。🚀🚨
这使用了来自 @GPU_MODE 社区的 AMD 上游内核。我们在下面进行解释 👇 1/6🧵@
磷化铟 (InP) 激光器突然引起了所有人的兴趣,因为它突然成为计算中更具战略性的组件之一。随着光连接越来越接近封装,每个光引擎和激光源都不可避免地运行在 InP 激光器上。但供应跟不上需求,特别是对于支持近封装光连接的连续波 (CW) 分布式反馈 (DFB) 激光器。(1/2)🧵
@![图片 1,共 1 张]()
你是否曾好奇,为什么 PCB(印制电路板)行业的人总是把 “M8” 或 “M9” 像魔法咒语一样随口挂在嘴边?
“M” 源自松下电气(Panasonic)的 Megtron 系列——长期以来,该系列一直是低损耗、高速覆铜板(CCL)的行业标杆。从 Megtron 4 到 Megtron 8,每一代产品都逐步降低了介电损耗因子(Df),这意味着在高频下信号损失更少。由于 Megtron 设定了行业标准,它已成为性能层级的行业通用术语,而不再仅仅是松下独有的零件编号。如今说 “M8 级”,仅仅意味着 “符合 Megtron 8 的电学规格”——无论是由松下、EMC 还是 Doosan 制造。随着 AI 服务器对 SerDes 速度要求越来越高,高端 CCL 已成为关键的瓶颈材料。这使得它成为整个硬件供应链中竞争最激烈、增长最快的细分市场之一。